Les “chat leaks” reviennent. Et ce n’est pas juste “un problème ChatGPT”.
En novembre 2026, des transcriptions liées à Notion AI ont été exposées suite à un incident chez un fournisseur (Fireworks AI). Notion a communiqué sur une portée inférieure à 1% des workspaces clients. Peu importe le pourcentage. Le signal est clair : tes données peuvent sortir de ton SI via n’importe quelle brique IA intégrée à un SaaS, et via toute sa chaîne de sous-traitants.
On a déjà eu des rappels concrets : bug ChatGPT du 20 mars 2023 (titres de conversations visibles, et risque sur des infos de paiement pour une fraction d’abonnés Plus), cas Samsung où des employés ont collé du code et des infos internes, et les régulateurs qui se sont engouffrés dans le sujet.
Le vrai danger, ce n’est pas “le modèle” en soi. C’est l’usage réel, les droits d’accès, et les outils que tes équipes branchent sans que tu le saches. L’IA ne crée pas toujours une fuite au sens “piratage”. Elle accélère la découverte. Si tes partages sont trop ouverts, Copilot ou un moteur IA va retrouver des infos sensibles plus vite, plus largement. Effet business identique : ça circule.
Objectif de cet article : te donner un plan simple, actionnable, en 7 contrôles. Pas une usine à gaz. De quoi réduire le risque LLM, cadrer la sécurité ChatGPT en entreprise, et activer un minimum de DLP IA et de traçabilité. Et si ça part quand même, tu repars avec un protocole d’incident en 30 minutes.
Avant de parler contrôles : distingue 3 scénarios (sinon tu protèges mal)
- Scénario A : incident chez le fournisseur (bug, mauvaise config, sous-traitant compromis). Exemple typique : transcriptions exposées.
- Scénario B : mauvais usage interne (copier-coller de secrets, docs clients, RH). Exemple typique : “je colle un contrat pour le résumer”.
- Scénario C : droits d’accès trop larges (oversharing). L’IA ne “fuite” pas, mais elle donne une lampe torche à tout le monde dans un hangar mal rangé.
Les 7 contrôles ci-dessous couvrent les trois. Si tu n’en fais que 2 ou 3, tu as un faux sentiment de sécurité.
La matrice dirigeant : ce qui peut aller dans un LLM, et ce qui est interdit
Tu veux une règle simple : “outil autorisé” ne veut jamais dire “données autorisées”. La règle, c’est la nature de la donnée + la finalité + le cadre fournisseur.
Autorisé (par défaut) : OK pour copiloter, reformuler, structurer
- Contenus publics : pages web, brochures, posts publiés, communiqués déjà sortis.
- Interne non sensible : procédures génériques, checklists sans infos clients, modèles de mails sans contexte réel.
- Données agrégées : tendances, stats globales sans granularité identifiante.
- Textes “nettoyés” : extraits anonymisés et décontextualisés (voir contrôle 3).
Autorisé sous conditions (cadre + besoin réel + minimisation)
- Extraits de contrats : seulement clauses nécessaires, noms et éléments identifiants masqués, pas le document complet.
- Tickets support : si anonymisés (pas de nom, pas d’email, pas d’ID de compte, pas d’adresse IP si inutile).
- Docs internes “Confidentiel” : uniquement via un environnement entreprise validé (SSO, logs, clauses, opt-out entraînement si applicable), et avec DLP sur les champs critiques.
Interdit (point final) : pas dans un LLM, même “Entreprise”, sauf circuit dédié validé
- Secrets : mots de passe, clés API, tokens, secrets applicatifs, configs sensibles.
- Données RH nominatives : salaires, évaluations, sanctions, dossiers médicaux, pièces d’identité.
- Données clients identifiantes sans base et sans cadre : noms, emails, numéros, adresses, IBAN, données de santé, etc.
- Stratégie et M&A : projets d’acquisition, négociations, listes de prix non publics, marges par client.
- Données réglementées : tout ce qui te mettrait en défaut contractuel, RGPD, secret pro, clauses de confidentialité.
Si tu veux être carré : affiche cette matrice partout où l’IA est utilisée. Dans le wiki, dans l’outil, dans l’onboarding. Une règle non visible est une règle non appliquée.
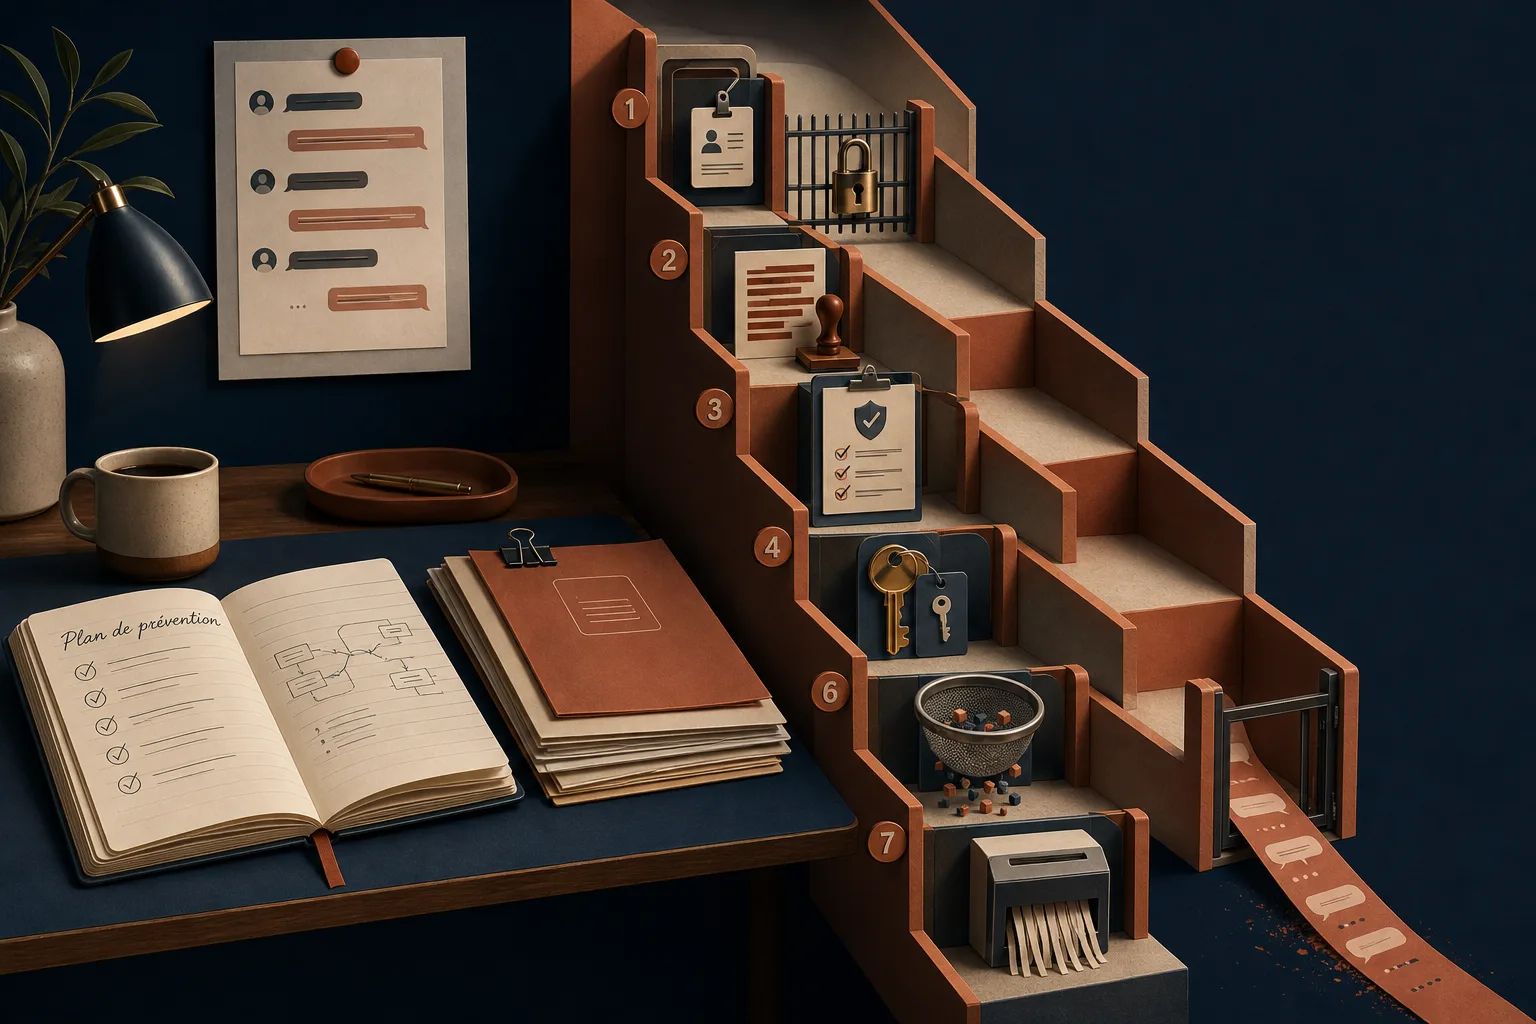
Plan de prévention en 7 contrôles (simple, testable, pilotable)
Contrôle 1 : classification express des données (2 heures, pas 2 mois)
Tu n’as pas besoin d’un référentiel à 48 niveaux. Tu as besoin d’un langage commun.
- Public : diffusé librement.
- Interne : interne, pas sensible.
- Confidentiel : fuite = impact commercial, juridique, image.
- Secret : fuite = impact majeur (pénalités, perte client clé, litige, sécurité).
Décisions de dirigeant à trancher tout de suite :
- Qui a le droit de classer “Secret” (et de déclasser) ?
- Quelles données sont “Secret” par défaut (ex : clés, salaires, M&A, code critique) ?
- Quel est le principe : si doute, on classe au niveau au-dessus.
Livrable : une page A4, une table simple, 10 exemples de ton business.
Contrôle 2 : règles de saisie LLM (10 règles max, sinon personne ne les lit)
Tu veux des règles testables. Pas “faites attention”.
- Règle 1 : jamais de secrets (mots de passe, clés API, tokens).
- Règle 2 : jamais de données RH nominatives.
- Règle 3 : jamais de données client identifiantes sans anonymisation.
- Règle 4 : pas de documents complets si un extrait suffit.
- Règle 5 : toujours minimiser (ce qui n’est pas nécessaire ne part pas).
- Règle 6 : interdiction de coller un export brut CRM/ERP.
- Règle 7 : si c’est “Confidentiel” ou “Secret”, outil approuvé + canal approuvé.
- Règle 8 : pas de connecteurs ajoutés sans validation (Drive, Gmail, Slack, SharePoint, etc.).
- Règle 9 : si tu ne peux pas expliquer la finalité en une phrase, tu ne le fais pas.
- Règle 10 : en cas de doute, stop et escalade (qui, comment : une adresse, un canal Teams/Slack).
Astuce terrain : ajoute 5 exemples “OK / Pas OK” avec des cas réels chez toi (contrat, ticket client, demande RH, mail fournisseur, extraction Excel).
Contrôle 3 : standard de redaction et d’anonymisation (pas le bricolage “j’enlève le nom”)
Erreur classique : “j’ai retiré le nom, donc c’est anonymisé”. Non. Beaucoup de contenus restent ré-identifiables via le contexte : secteur, localisation, montant, échéance, détail d’incident, nom de projet.
Ton standard simple :
- Remplacement : Client_A, Client_B, Fournisseur_X, Projet_Y.
- Suppression : numéros, emails, adresses, identifiants, références de contrat.
- Généralisation : “un client du secteur santé” au lieu de “clinique X à Lyon”.
- Masquage montants si non nécessaires : “montant à 6 chiffres” au lieu de “142 380 euros”.
- Découpage : tu envoies uniquement la clause ou le paragraphe utile.
Si tu veux aller plus loin, garde un protocole de tests anti-réidentification. Tu peux t’appuyer sur ce contenu du site : https://jimmymanin.com/blog/anonymisation-rgpd-et-ia-checklist-terrain-tests-anti-reidentification-edpb-2026
Contrôle 4 : DLP IA (bloquer l’évidence, accepter quelques faux positifs)
Le DLP IA, ce n’est pas un fantasme. C’est juste : détecter et empêcher la sortie de certains patterns (IBAN, CB, NIR, secrets, mots de passe, clés), selon les canaux.
Approche pragmatique :
- Commence par 5 types de données : secrets, pièces d’identité, données bancaires, données de santé, RH nominatif.
- Choisis tes canaux : navigateur (upload et copier-coller), endpoints, M365 (SharePoint/OneDrive/Teams), email.
- Décide ton niveau de friction : blocage dur sur “Secret”, warning sur “Confidentiel”.
Oui, tu auras des faux positifs. C’est un arbitrage business : combien de bruit tu acceptes pour éviter une fuite de données IA qui coûte un client ou déclenche une notification légale.
Contrôle 5 : logs et audit (preuve, pas intuition)
Après un incident, la question n’est pas “est-ce que quelqu’un a collé un fichier ?”. La question est “qui, quand, quoi, via quel outil, depuis quel compte, et vers quel fournisseur”.
- Centralise l’accès via SSO quand possible.
- Active l’audit sur les outils IA approuvés (usage, connecteurs, exports, partages).
- Garde une rétention suffisante (au moins plusieurs semaines, idéalement plus selon ton risque).
- Fais un test mensuel : “reconstruire une semaine d’usage IA” en 30 minutes. Si tu n’y arrives pas, tu n’es pas prêt.
Pour cadrer la partie MFA, logs et accès côté conformité, tu peux aussi t’appuyer sur : https://jimmymanin.com/blog/rgpd-article-32-et-ia-la-checklist-securite-cnil-mfa-logs-acces-en-1-heure
Contrôle 6 : accès, identités, permissions (le piège Copilot, mais pas que)
Les éditeurs le disent eux-mêmes : une IA comme Copilot ne doit exposer que ce à quoi l’utilisateur a déjà accès. Donc si tes permissions sont trop ouvertes, tu as un problème d’oversharing. L’IA ne le crée pas. Elle le rend visible et exploitable.
Plan simple :
- Stop aux liens “tout le monde” dans SharePoint/Drive.
- Revue des groupes : qui est dans “Finance”, “RH”, “Direction”, “All staff”.
- Nettoyage des héritages : dossiers sensibles qui héritent d’un accès large.
- Principe du moindre privilège : par rôle, pas par personne.
Indicateur utile : “combien de dossiers Confidentiel/Secret sont accessibles à plus de X personnes”. Tu veux que ça baisse chaque mois.
Contrôle 7 : revue fournisseurs et chaîne de sous-traitants (le point aveugle des dirigeants)
L’incident Notion AI rappelle un truc simple : tu n’achètes pas juste un outil. Tu achètes un fournisseur, et parfois les fournisseurs de ton fournisseur.
- Exige une cartographie des sous-traitants impliqués dans la fonctionnalité IA (au moins les catégories et localisations).
- Vérifie les options : entraînement sur tes données, rétention, export, localisation, isolation tenant, chiffrement.
- Regarde la sortie : comment récupérer tes données et tes logs si tu changes d’outil.
- Teste le support incident : délais, canal, engagement de notification.
Si tu veux une checklist d’achat sans te faire enfumer, tu peux t’appuyer sur : https://jimmymanin.com/blog/acheter-une-solution-ia-sans-se-faire-enfumer-la-checklist-dirigeant-inspiree-du-guide-dinum
Le protocole incident “chat leak” en 30 minutes (spécial dirigeant)
Objectif : arrêter l’hémorragie, préserver la preuve, décider vite, notifier correctement. Pas faire une réunion.
0 à 5 minutes : qualifier et geler
- Qui pilote : toi ou un owner désigné (DSI/RSSI si tu en as, sinon un binôme DSI + juridique/DPO).
- Tu qualifies : quel outil IA ? quelle équipe ? quel type de donnée ? quel volume ? exposition interne ou externe ?
- Tu figes les preuves : captures, liens, identifiants de conversation, horodatage, comptes concernés. Pas de nettoyage sauvage.
5 à 10 minutes : couper ce qui doit être coupé (sans tout cramer)
- Coupe ciblée : désactive le connecteur incriminé, la fonctionnalité IA, ou l’accès du groupe concerné.
- Si doute sérieux : coupe l’outil IA en SSO (suspension temporaire) ou force un blocage réseau, selon ton architecture.
- Révoque les tokens et sessions si l’incident touche des identifiants.
10 à 20 minutes : évaluer l’impact business et légal
- Impact business : clients touchés ? données commerciales sensibles ? risque de chantage ?
- Impact contractuel : clauses de confidentialité, exigences client (notamment grands comptes).
- Impact RGPD : données perso ou pas ? identifiantes ? volume ? catégories sensibles ?
À ce stade, tu ne cherches pas la perfection. Tu cherches une décision : “incident mineur sous contrôle” ou “incident majeur à traiter comme violation potentielle”.
20 à 30 minutes : notifier en interne, lancer l’enquête, préparer les communications
- Interne : message clair aux équipes concernées (ce qui est coupé, ce qui est interdit, quoi remonter).
- Fournisseur : ouvrir un ticket incident, exiger chronologie, périmètre, mesures, et logs si disponibles.
- Clients : si nécessaire, prépare un message factuel (ce que tu sais, ce que tu fais, prochaines étapes). Pas de spéculation.
- Autorités : si données perso à risque, tu pré-alertes ton DPO/conseil pour décider de la notification dans les délais applicables.
Règle d’or : une fuite de données IA mal gérée coûte plus cher en confiance qu’en technique.
Checklist “dès cette semaine” (si tu veux du concret, pas un chantier)
- 1 heure : écris ta matrice “OK / sous conditions / interdit” et envoie-la à toute l’entreprise.
- 2 heures : classification en 4 niveaux + 10 exemples adaptés à ton métier.
- 2 heures : 10 règles de saisie LLM + canal d’escalade + sanctions simples (au moins : rappel, retrait accès).
- 1 demi-journée : fais un premier nettoyage des partages “tout le monde” sur Drive/SharePoint.
- 1 demi-journée : active logs/audit sur les outils IA approuvés et vérifie que tu peux reconstituer l’usage.
- 30 minutes : écris ton protocole incident “chat leak” et nomme les responsables (qui coupe quoi, qui parle à qui).
Ce que tu gagnes vraiment avec ce plan
Tu réduis le risque de fuite de données IA sans tuer l’usage. Tu évites le réflexe “on interdit tout” qui pousse au Shadow AI. Tu rends les incidents gérables, parce que tu sais quoi couper, tu as des logs, et tu as une doctrine simple sur les données.
Si tu veux traiter le sujet Shadow AI à l’échelle, en mode dirigeant (sans bloquer les équipes), tu peux compléter avec : https://jimmymanin.com/blog/shadow-ai-a-lechelle-reprendre-le-controle-en-30-jours-sans-bloquer-les-equipes
Prochaine étape : prends ton outil IA le plus utilisé (ChatGPT, Claude, Gemini, Copilot, ou une IA intégrée à ton CRM/support). Applique les 7 contrôles dessus, un par un. Tu n’as pas besoin d’être parfait. Tu as besoin d’être prêt avant le prochain “chat leak”.