Le scénario classique: une clé fuit, et tu payes (parfois très cher)
Une clé API d’un service IA (OpenAI, Anthropic, Gemini, etc.) qui fuit, ce n’est pas juste “un souci technique”. C’est souvent un incident financier immédiat, et parfois un incident données par ricochet.
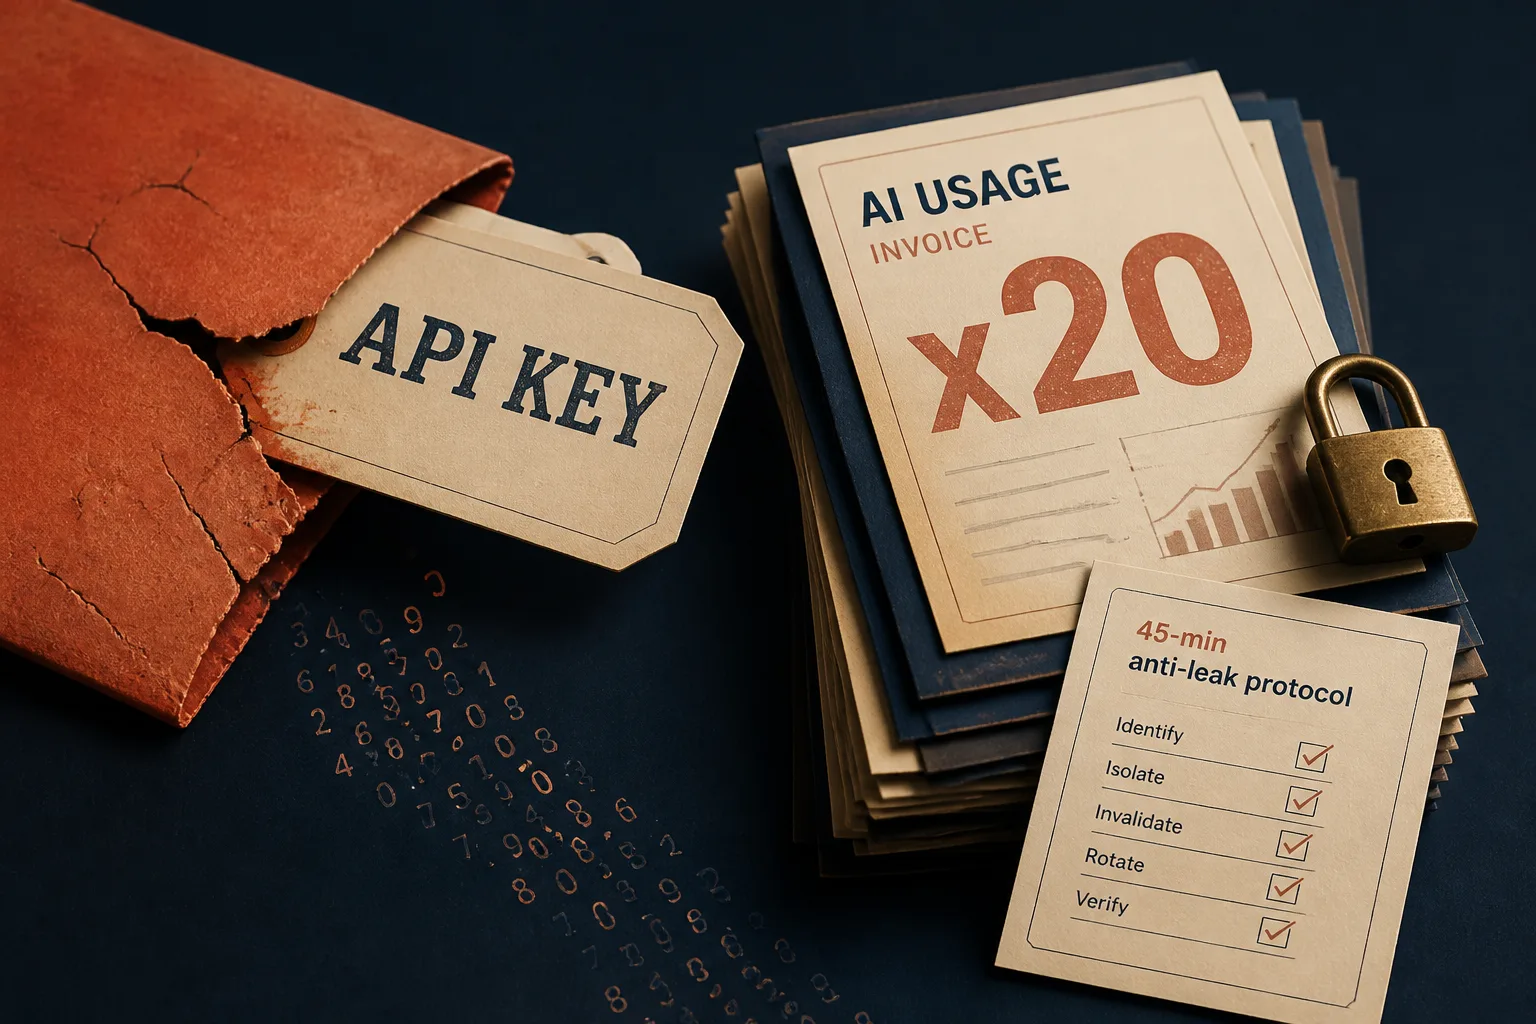
Pourquoi ça part en vrille si vite? À cause d’une asymétrie brutale: l’attaquant ne paie rien, toi tu payes tout. Une fois la clé récupérée, il peut automatiser des appels à la chaîne jusqu’à vider tes crédits ou taper ton plafond. C’est la mécanique la plus fréquente derrière les “factures qui explosent” après un leak de clé API IA (typiquement OpenAI), parfois suite à une fuite bête dans des en-têtes HTTP ou du code exposé.
Et ne te raconte pas d’histoire: si ta clé est “large” (pas de séparation dev/prod, pas de quotas, pas d’alerting, pas de scopes), tu as créé un point de défaillance unique qui transforme un incident banal en crise.
Pourquoi une fuite de clé API IA devient un incident “argent + données”
1) Fraude à l’usage: on exécute des appels, tu finances
Le mode opératoire est simple:
- Récupérer une clé (repo GitHub, logs, support, capture réseau, variable d’environnement exposée, outil no-code mal configuré).
- Lancer un script qui fait des requêtes en boucle.
- Choisir des modèles et des tailles de contexte coûteux pour maximiser la facture, ou faire du volume.
Tu peux avoir des rate limits (débit), et quand même te faire plomber par une attaque “lente mais chère” (grosses requêtes), ou “rapide” (burst). Les deux contrôles sont différents, donc il faut les deux.
2) Exfiltration indirecte: la clé n’est pas “une fuite de données” toute seule… mais ton architecture peut la rendre explosive
Une API key ne donne pas magiquement accès à ton CRM. Par contre, si ton application:
- envoie des données sensibles dans les prompts,
- upload des fichiers pour traitement,
- accède à des endpoints internes “protégés” uniquement par cette clé,
- ou expose des logs/prompt templates contenant des infos business,
alors l’abus de la clé peut devenir une fuite de données. Le risque dépend de ton design, pas “de l’API” en elle-même.
3) Tendance à surveiller côté dirigeant: “récolte de clés” + distillation
En 2026, la logique n’est plus seulement “je te fais payer”. Il y a aussi de la “récolte de clés” à grande échelle (key harvesting) parce que ces clés servent à alimenter des pipelines, collecter, distiller, tester, et industrialiser des usages non autorisés. Autrement dit: ton budget est une cible, mais tes accès aussi.
Le protocole anti-fuite + anti-dépassement en 45 minutes
Objectif: réduire le blast radius. Même si une clé fuit demain, l’impact doit rester contenu: peu d’argent perdu, peu (idéalement zéro) données exposées, et capacité de prouver ce qui s’est passé.
0 à 5 minutes: stoppe l’hémorragie (si tu suspects un abus)
Tu vois une hausse brutale sur le dashboard (OpenAI/Anthropic) ou une alerte carte bleue? Tu coupes d’abord, tu enquêtes ensuite.
- Révoque/supprime la clé suspecte immédiatement (une clé compromise reste valide tant que tu ne la tues pas).
- Si tu as des “projects” ou équivalent, coupe le projet le plus suspect en priorité (meilleur confinement).
- Note l’heure exacte et qui a pris la décision (ça te servira pour reconstituer l’incident).
Point important: sur OpenAI, une alerte de dépense prévient, mais ne stoppe pas le trafic. Si tu veux que ça s’arrête, il faut un hard spend limit (qui fait échouer les requêtes quand la limite est atteinte, souvent via des erreurs 429 avec des codes du type organization_spend_limit_exceeded ou project_spend_limit_exceeded).
5 à 15 minutes: inventaire minimal (à faire même à la main)
Tu listes, vite. Pas besoin d’un outil fancy. Une note partagée suffit.
- Quelles clés existent (OpenAI, Anthropic, Google, Azure/OpenAI, outils tiers qui embarquent des clés, etc.).
- Où elles sont utilisées: backend, frontend, appli mobile, CI/CD, scripts internes, Zapier/Make/n8n, plugins, notebooks, postes dev.
- Quel environnement: dev, staging, prod.
- Qui “possède” la clé: personne, équipe, prestataire, projet.
- Quel niveau de droits: accès à quels endpoints, fichiers, assistants/agents, tools, etc.
Décision de dirigeant: si tu ne sais pas “où est la clé”, tu ne maîtrises pas ton risque. Donc tu imposes une règle simple: toute clé a un propriétaire, un usage, un environnement, une date de rotation.
15 à 25 minutes: rotation propre (sans se tirer une balle dans le pied)
Rotation = générer une nouvelle clé et retirer l’ancienne. Mais fais-le proprement:
- Crée une nouvelle clé par environnement (au minimum: dev et prod séparés).
- Déploie la nouvelle clé (secret manager, variables d’environnement, config CI/CD).
- Vérifie que la prod tourne.
- Révoque l’ancienne clé.
Si tu fais l’inverse (révoquer d’abord), tu risques une panne. Donc: remplacer puis couper, sauf si tu es en mode hémorragie (là, tu coupes d’abord).
25 à 33 minutes: scopes minimaux (le vrai levier anti-catastrophe)
Le sujet n’est pas “avoir une clé”. Le sujet, c’est “qu’est-ce qu’elle permet”.
- Une clé par produit/projet (ex: “Support bot”, “Extraction factures”, “RAG interne”).
- Une clé par environnement (dev, staging, prod).
- Une clé par canal sensible si besoin (ex: génération d’images séparée du texte, si la partie image est plus coûteuse).
Résultat: si une clé dev fuit, tu ne finances pas la prod. Si une clé “image” fuit, tu ne casses pas ton budget “LLM texte”. Tu cloisonnes le risque comme tu cloisonnes des budgets.
33 à 38 minutes: quotas + hard limits + rate limits (les trois ceintures)
Tu poses trois types de garde-fous:
- Hard spend limit: coupe net quand la dépense trackée atteint la limite. Sur OpenAI, c’est ça qui stoppe réellement les requêtes (erreurs 429 côté client).
- Alertes: utile, mais insuffisant. Ça sert à te réveiller, pas à stopper l’attaque.
- Rate limits: limite le débit. Indispensable contre les bursts, mais pas une protection budgétaire.
Point de vigilance: sur OpenAI, les spend limits que tu configures sont distinctes de la limite d’usage “approuvée”. Donc tu peux (et tu dois) mettre tes propres plafonds, même si le fournisseur t’autorise plus.
Décision simple: tout ce qui est en prod doit avoir un hard limit bas au départ, puis tu l’augmentes quand c’est stable et maîtrisé.
38 à 42 minutes: alerting opérationnel (pas un mail que personne ne lit)
Une alerte utile, c’est une alerte qui déclenche une action. Minimum viable:
- Alerte budget à 50%, 80%, 95% du hard limit (canal: Slack/Teams + email).
- Alerte anomalie sur volume de requêtes (x3 vs moyenne horaire) et sur modèles coûteux.
- Alerte erreurs 429 qualifiées: toutes les 429 ne sont pas “retry”. Certaines indiquent un dépassement de quota/spend et demandent une action humaine.
Si tu as des automations qui “réessayent” en boucle sur une 429 de spend limit, tu peux aggraver l’incident. Tu veux un comportement: stop + escalade.
42 à 45 minutes: séparation dev/prod + coffre-fort à secrets + règles prestataires
Les trois règles qui éliminent 80% des fuites:
- Jamais de clé IA dans le frontend (navigateur, app mobile). Si tu dois appeler un LLM, tu passes par ton backend, avec authentification, logs, quotas, et filtrage.
- Secret manager: les clés vivent dans un coffre-fort (AWS Secrets Manager, GCP Secret Manager, Azure Key Vault, Vault, ou à défaut un gestionnaire de secrets sérieux). Pas dans un fichier .env qui se balade, pas dans un Notion, pas dans un ticket support.
- Prestataires: pas de clé partagée. Jamais. Tu donnes une clé dédiée par prestataire, limitée, avec date de fin, et rotation imposée.
Et tu ajoutes un réflexe simple côté code et repo:
- Secret scanning et push protection sur GitHub. Depuis 2026, GitHub indique pouvoir bloquer par défaut certaines clés (ex: Anthropic) via la push protection, et transmettre aux partenaires pour révocation si un secret finit dans un repo public. Ça ne remplace pas ta gouvernance, mais ça rattrape des boulettes.
Mini-kit de décision dirigeant: couper, plafonner, ou observer?
Tu veux décider vite, sans débat stérile.
Cas 1: tu vois une explosion nette (coûts ou volume)
- Action: coupe (révoque la clé ou désactive le projet).
- Pourquoi: chaque minute coûte. Et l’attaquant n’a aucun frein.
- Ensuite: rotation, hard limits plus bas, analyse.
Cas 2: tu vois une dérive mais pas une attaque (usage interne mal cadré)
- Action: plafonne d’abord (hard spend limit par projet), puis ajuste.
- Pourquoi: tu évites de casser la prod, tout en imposant une discipline budgétaire.
- Ensuite: tu mets un propriétaire et tu forces la séparation par environnement/projet.
Cas 3: tu as un doute (signal faible)
- Action: resserre sans couper (rate limit + hard limit bas + alerting agressif).
- Pourquoi: tu limites l’impact si c’est réel, et tu collectes des preuves.
Comment prouver ce qui s’est passé (et éviter le “on ne saura jamais”)
Tu ne pourras pas toujours identifier “qui” a volé la clé. Mais tu peux prouver quoi, quand, combien, depuis où (parfois), et quelle clé.
La checklist preuve en 20 minutes
- Timeline: heure de début de l’anomalie, heure de coupure, heure de rotation.
- Export usage: captures du dashboard (usage par jour/heure si dispo), coûts par modèle, par projet.
- Logs applicatifs: logs du backend qui appelle l’API (request id interne, user, endpoint, taille approx, statut).
- Corrélation: pics de 429, pics de latence, déploiements récents, changement de config CI/CD.
- Recherche de fuite: scan rapide des repos (publics et privés), des snippets, des tickets, des outils no-code, des logs. Objectif: trouver le point d’exposition.
Le truc qui change tout: une clé = un contexte
Si tu as une seule clé pour tout, tu ne peux pas attribuer. Si tu as une clé par projet et par environnement, tu peux dire: “La fuite vient de dev sur tel service”, et tu contiens.
Les erreurs qui te feront revivre l’incident
- Une clé unique partagée entre prod, dev, prestas, scripts.
- Pas de hard limit, seulement des alertes. Les alertes n’arrêtent rien.
- Retry aveugle sur les erreurs 429 (tu transformes une limite en tempête de requêtes).
- Clé dans le frontend: là, tu offres la clé au public.
- Pas de secret manager: les clés finissent dans des endroits impossibles à gouverner.
Si tu veux aller plus loin (sans usine à gaz)
Deux lectures utiles pour cadrer le risque “accès” et “fuite” en entreprise, dans la même logique directe et actionnable:
- Fuite de données via IA : ton plan de prévention en 7 contrôles avant le prochain chat leak
- LLM-jacking : plan dirigeant en 45 minutes pour couper le risque (ChatGPT, Claude, Gemini)
Le plan d’action que tu peux lancer maintenant (et finir avant ton prochain call)
- Tu imposes: une clé par projet et par environnement, propriétaire nommé, rotation planifiée.
- Tu blindes: hard spend limits + rate limits + alerting opérationnel.
- Tu professionnalises: secret manager, jamais de clé côté frontend, prestataires avec clés dédiées et expirables.
- Tu rends prouvable: logs backend, exports d’usage, timeline d’incident.
Ton objectif n’est pas “zéro fuite” (personne ne peut te promettre ça). Ton objectif est simple: si ça fuit, ça ne te tue pas. Ni en facture, ni en données, ni en chaos opérationnel.
Mots-clés couverts: sécuriser clés API IA, API key leak OpenAI Anthropic.