Tu veux automatiser. Pas créer une usine à incidents.
Les agents IA font rêver parce qu’ils “comprennent” un email, un PDF, une demande floue. Le RPA rassure parce qu’il clique toujours pareil. Les deux ensemble, c’est puissant. Et dangereux si tu mélanges tout.
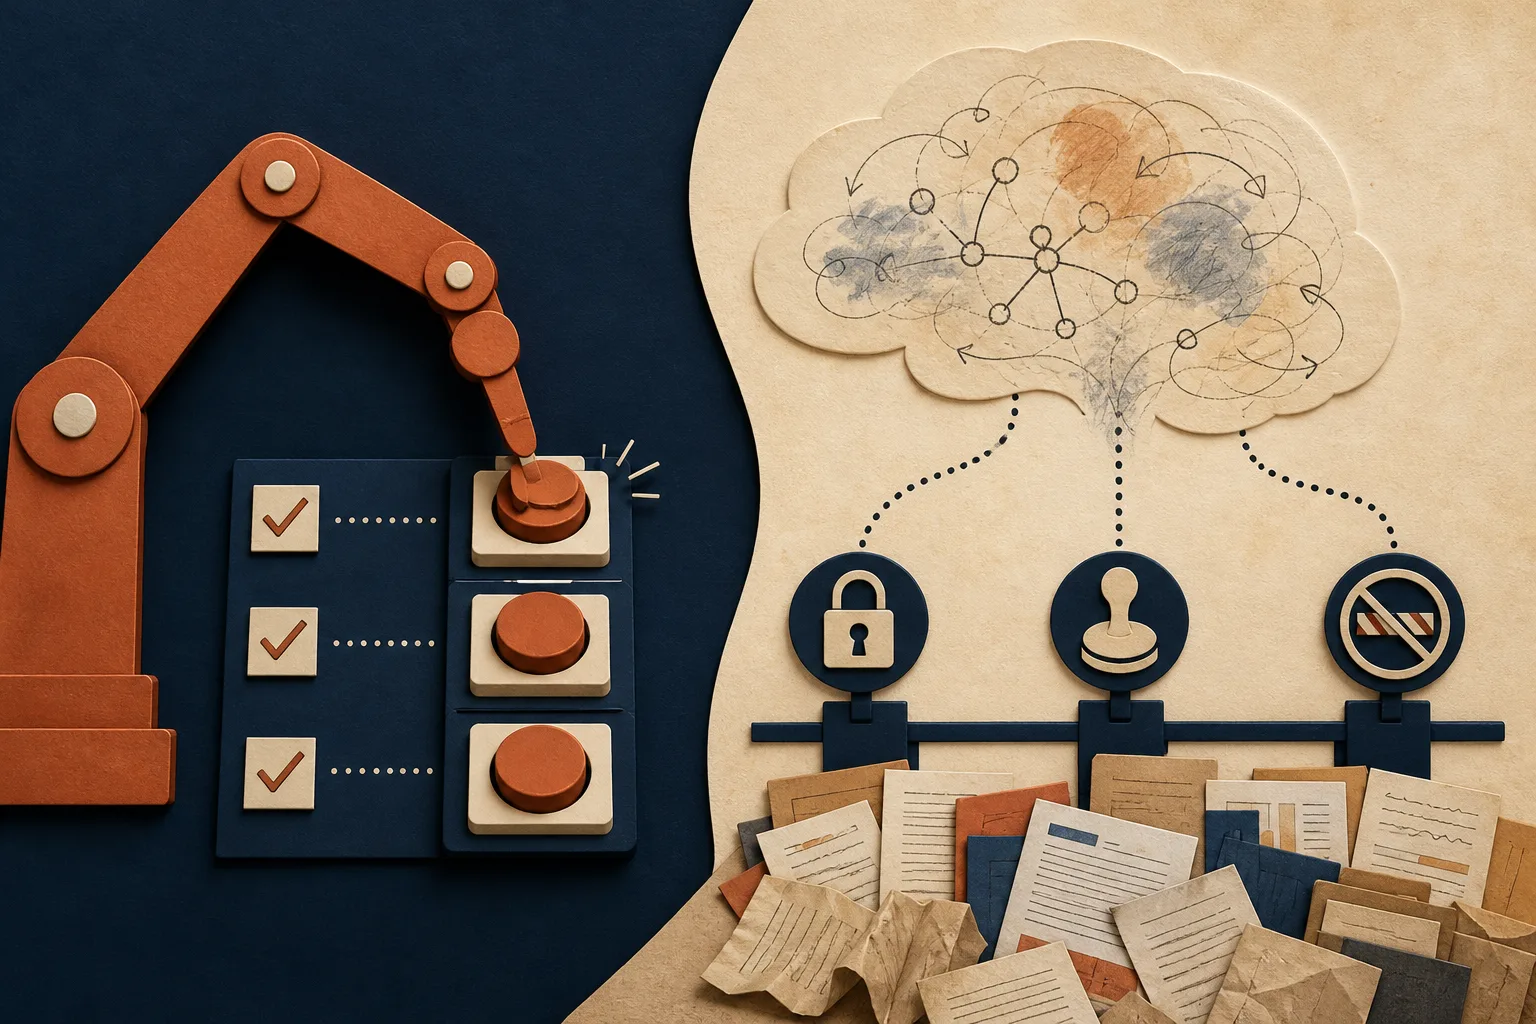
Règle simple : RPA = le bras fiable. Agent IA = le cerveau probabiliste. Le bras exécute. Le cerveau propose, classe, extrait, prépare. Mais ne doit pas décider seul sur l’irréversible.
Ça tombe bien : le RPA n’est pas “mort”. Gartner estime que le marché logiciel RPA a encore crû de 14,5% en 2024, à 3,6 Md$. Et les agents pleinement autonomes en prod restent minoritaires : Gartner parle de 15% de responsables applicatifs IT qui envisagent/pilotent/déploient des agents “fully autonomous” (enquête 2025). Donc si tu es dirigeant de PME, tu n’es pas en retard : tu es dans la norme si tu fais ça proprement.
Objectif de cet article : un blueprint opérationnel pour automatiser 3 processus avec une approche agent IA RPA, plus les garde-fous qui évitent le chaos (erreurs silencieuses, dérives, incidents, fuite de données).
Le modèle mental : orchestration mixte, pas “un outil magique”
Les éditeurs convergent : UiPath pousse “agentic automation”, Microsoft Copilot Studio relie agents et Power Automate/RPA, Automation Anywhere parle “agentic process automation”. Traduction terrain : tu vas piloter une orchestration composée de briques :
- Agent : lecture, compréhension, extraction, décision proposée, rédaction.
- RPA : actions dans les applis (ERP, CRM, portail fournisseur, legacy), exécution répétable.
- Règles : seuils, contrôles de cohérence, “si… alors…”.
- Humain : validation, arbitrage, escalade.
- Logs + monitoring : preuve, audit, mesure du gain et des incidents.
La valeur vient de l’end-to-end. Pas d’une démo où l’agent ouvre un navigateur. McKinsey le répète côté GenAI : sans orchestration solide, tu restes en pilote éternel.
Le blueprint opérationnel en 6 étapes (pour déployer des agents IA en production)
Étape 1 : sélectionner 3 processus candidats (ROI rapide, risque faible)
Tu ne commences pas par la paie, ni par la trésorerie, ni par “tout le support client”. Tu choisis 3 processus où l’automatisation processus PME est rentable et où l’erreur ne te met pas au tapis.
Critères de sélection (score 1 à 5) :
- Volume : au moins hebdo, idéalement quotidien.
- Répétabilité : 70% des cas suivent un chemin standard.
- Données déjà numériques : email, PDF, formulaires, exports.
- Faible irréversibilité : pas de paiement automatique, pas de résiliation, pas de suppression.
- Exceptions recensables : tu peux lister les 10 motifs principaux d’échec.
- Accès applicatifs réalistes : API ou interface stable pour le RPA.
Trois bons candidats typiques (quasi universels en PME/ETI) :
- Pré-contrôle factures fournisseurs : extraction champs, vérifs simples, création de brouillon, mise en validation.
- Création/mise à jour CRM depuis email + PJ : classifier la demande, extraire infos, créer tâche/opportunité, ranger les pièces.
- Relances et suivi : relances clients/fournisseurs selon règles (âge de facture, statut litige), génération de mails + journal.
Décision de dirigeant : pour chaque processus, tu fixes un plafond de risque (montant, type de client, données sensibles) et un objectif (heures gagnées, baisse erreurs, délai réduit).
Étape 2 : standardiser les entrées et les sorties (sinon l’agent improvise)
Un agent sans standard, c’est un stagiaire brillant sans procédure. Il compensera. Il inventera. Et il te coûtera cher en “taxe de vérification”.
Standard d’entrée (à écrire sur 1 page) :
- Formats acceptés : PDF natif, PDF scanné, email, CSV, etc.
- Champs obligatoires : SIREN, n° facture, date, montant HT/TTC, devise, n° commande…
- Dictionnaire : nom des champs, formats, tolérances (ex : date ISO, décimales).
- Règles de nommage des pièces et de stockage.
Standard de sortie (non négociable) :
- Sortie structurée : JSON ou tableau colonnes fixes (pas du texte libre).
- Statut : OK, A_VERIFIER, REJET.
- Justificatifs : preuve (page, extrait, lien vers source, champs utilisés).
- Trace : identifiant de run, horodatage, version prompt/agent.
Tu réduis la liberté de l’agent. Et tu rends le système auditable.
Étape 3 : découper en micro-tâches agentiques + actions RPA (pattern robuste)
Le pattern qui marche en IA agentique entreprise :
- Agent : lit, classe, extrait, propose.
- Règles : contrôles déterministes (seuils, cohérences, listes).
- RPA : exécute dans l’outil (création, saisie, dépôt, envoi).
- Agent : rédige le résumé, explique, prépare la validation si nécessaire.
Règle de design : l’agent ne clique pas sur une action irréversible sans contrôle. Tu veux éviter le scénario “ça avait l’air plausible”.
Exemple sur une facture :
- Agent extrait : fournisseur, IBAN (si présent), montant, échéance, n° commande, TVA.
- Règles : montant = somme lignes, fournisseur connu, commande existante, seuil validation.
- RPA : crée un brouillon de facture dans l’ERP et attache le PDF.
- Agent : produit un résumé “prêt à valider” + liste des anomalies.
Étape 4 : définir les contrôles humains (Human-in-the-loop, mais designé)
“Human-in-the-loop” n’est pas une phrase rassurante. C’est un design de contrôle. Le NIST AI RMF te donne la logique : gouverner, cartographier, mesurer, mitiger. Toi, tu le traduis en règles simples.
3 niveaux d’autonomie (clairs, mesurables) :
- Niveau 1, assisté : l’agent prépare, l’humain exécute (utile semaine 1).
- Niveau 2, semi-auto : le RPA exécute, mais validation obligatoire sur certains cas.
- Niveau 3, straight-through : 0 validation uniquement si risque faible + confiance élevée + rollback possible.
Déclencheurs de validation obligatoire (exemples) :
- Montant > X euros.
- Nouveau fournisseur, nouveau client, nouveau RIB/IBAN.
- Donnée manquante ou incohérence détectée.
- Extraction sur document scanné de mauvaise qualité.
- Confiance modèle sous seuil (ou “incertitude” via heuristique).
Escalade (quand l’agent doit s’arrêter) :
- Plus de N tentatives RPA.
- Captcha, MFA inattendu, page qui change.
- Cas non prévu (catégorie “AUTRE”).
- Suspicion fraude (RIB différent, demande urgente, ton inhabituel).
Pour cadrer les incidents avant de “laisser cliquer”, tu peux t’appuyer sur ce plan : https://jimmymanin.com/blog/agents-ia-et-incidents-reels-le-plan-de-controle-en-30-minutes-avant-de-laisser-cliquer.
Étape 5 : checklist de prérequis (avant la première exécution)
Si tu ne coches pas ça, tu vas “automatiser” et finir à éteindre des feux.
- Droits applicatifs : comptes dédiés (pas le compte perso d’un salarié), rôles minimalistes, séparation lecture/écriture.
- MFA : stratégie claire (sessions, comptes robots, coffre-fort, rotation).
- Gestion des exceptions : liste des exceptions connues + action attendue (retry, validation, rejet, escalade).
- Journalisation : logs agent + logs RPA + corrélation (run_id), conservation, accès restreint.
- Preuves : lien vers document source, extrait utilisé, version du prompt/agent.
- Escalade : canal unique (ticket, Teams/Slack, email), responsable nommé, SLA interne.
- Mode dégradé : si LLM down, si ERP down, si quotas explosent. Qui fait quoi.
- Garde-fous sécurité : filtrage données sensibles, limitation outils, sandbox si possible.
- Changement UI : si RPA sur interface, tu prévois la casse (tests, versioning, fenêtre de maintenance).
- Confidentialité : où partent les données, quelles options d’entraînement, quelles clauses.
Pour la partie fuite et branchements, garde ces deux ressources sous la main :
- https://jimmymanin.com/blog/connecteurs-ia-drive-gmail-slack-eviter-la-fuite-de-donnees-quand-tu-branches-un-agent
- https://jimmymanin.com/blog/fuite-de-donnees-via-ia-ton-plan-de-prevention-en-7-controles-avant-le-prochain-chat-leak
Étape 6 : instrumenter le suivi (sinon tu ne sais pas si tu gagnes vraiment)
Tu pilotes 4 métriques. Pas 40.
- Temps gagné net : minutes économisées moins minutes de vérification et de reprise.
- Taux d’erreur : erreurs détectées avant action, erreurs après action, erreurs client-facées.
- Taux d’incident : blocage RPA, dérive agent, bug connecteur, accès refusé.
- Taux d’escalade : % de cas qui finissent en humain (et pourquoi).
Ce que tu veux voir dès semaine 2 :
- les 5 exceptions les plus fréquentes,
- les 3 écrans RPA qui cassent le plus,
- les 10 champs les plus mal extraits,
- le coût par dossier (LLM + RPA + temps humain).
Et tu ajustes : standard d’entrée, seuils, règles, prompts, ou tu retires un processus si c’est un nid à exceptions.
3 processus concrets : design “agent IA RPA” sans te tirer une balle dans le pied
Processus 1 : pré-contrôle factures fournisseurs (compta)
Entrée : PDF + email. Sortie : JSON + statut + preuves.
- Agent : extrait champs, détecte anomalies (TVA, doublon, coordonnées bancaires).
- Règles : seuil montant, fournisseur existant, commande obligatoire ou non.
- RPA : crée brouillon dans ERP, attache PDF, affecte au bon circuit de validation.
- Humain : valide uniquement si statut A_VERIFIER ou montant > seuil.
Garde-fou clé : l’agent ne déclenche jamais un paiement. Il prépare.
Processus 2 : création et hygiène CRM depuis emails
- Agent : classe (lead, client, support, fournisseur), extrait société, contact, sujet, urgence.
- Règles : si domaine email inconnu, si secteur sensible, si doublon probable.
- RPA : crée lead/opportunité/ticket, log l’email, range PJ, assigne au bon commercial.
- Humain : valide seulement les “nouveaux comptes” ou gros deals.
Si tu bosses sur Salesforce et Copilot, tu peux t’inspirer de workflows anti app-switching (et de la gouvernance) ici : https://jimmymanin.com/blog/copilot-salesforce-7-workflows-concrets-anti-app-switching-gouvernance-preview.
Processus 3 : relances clients (avec règles, pas au feeling)
- Agent : génère un mail de relance adapté au contexte (historique, litige, promesse précédente).
- Règles : pas de relance si litige ouvert, si client stratégique sans validation, si facture contestée.
- RPA : envoie via boîte partagée, crée une note CRM, planifie la relance suivante.
- Humain : valide les relances “ton dur”, ou montants > seuil.
Garde-fou clé : pas d’envoi automatique au début. Tu passes en semi-auto, puis seulement ensuite en straight-through sur un segment à faible risque.
Modèle de ROI prudent (pas un château en Espagne)
Tu veux un calcul simple, pessimiste, défendable.
1) Gain brut temps
- Volume mensuel (N dossiers) x temps humain moyen avant (T0).
- Moins temps humain après (T1) incluant validation et reprises.
Gain net heures = N x (T0 - T1) / 60
2) Coûts
- Coût licences RPA / orchestration.
- Coût IA (tokens, appels, vision, embeddings si besoin).
- Coût run (VM/bot machines, supervision).
- Coût mise en place (jours homme internes + prestas).
- Coût contrôle (validation, audits qualité).
3) Risque (provision)
- Tu mets une ligne “incidents” dès le départ (ex : 5% du gain la première phase).
- Tu mets une ligne “maintenance” (UI qui change, règles qui évoluent).
ROI prudent mensuel :
- Valeur temps = gain net heures x coût chargé horaire.
- ROI = (valeur temps - coûts mensuels - provision risque) / coûts mensuels.
Si ton ROI n’est bon que “si tout marche parfaitement”, tu ne déploies pas. Tu réduis le périmètre, tu simplifies, ou tu changes de processus.
Pour chiffrer proprement la partie coût agent (sans te faire piéger), tu peux utiliser ce cadre : https://jimmymanin.com/blog/cout-dun-agent-ia-en-2026-chiffrer-par-tache-sans-te-faire-pieger-par-le-token.
Les garde-fous non négociables (sinon tu vas le regretter)
- Pas de secrets dans les prompts : tokens, mots de passe, clés API. Jamais.
- Comptes dédiés : un agent qui agit doit avoir des identités séparées, traçables.
- Logs exploitables : si tu ne peux pas expliquer “pourquoi il a fait ça”, c’est non.
- Limites d’action : allowlist d’outils et d’opérations. Pas d’accès “admin”.
- Kill switch : bouton stop, et stop automatique sur seuil d’incidents.
- Échantillonnage qualité : même en straight-through, tu contrôles X% des cas.
Pour la sécurité pure (droits, logs, sandbox), tu as une checklist utile ici : https://jimmymanin.com/blog/agents-ia-en-entreprise-checklist-securite-en-12-points-anti-fuite-avant-deploiement.
Plan d’action 10 jours : automatiser 3 processus sans partir en vrille
- Jour 1 : shortlist 6 processus, scoring volume/risque/exceptions.
- Jour 2 : choisir 3 processus, définir seuils d’irréversibilité, niveau d’autonomie initial (niveau 1 ou 2).
- Jour 3 : écrire standard d’entrée/sortie + dictionnaire de champs.
- Jour 4 : découper en micro-tâches agent/règles/RPA, définir points de contrôle humain.
- Jour 5 : checklist prérequis (droits, logs, escalade, mode dégradé).
- Jours 6-7 : build version 0 sur 1 processus, avec logs et preuves.
- Jour 8 : test sur un lot réel, mesurer taux d’escalade et erreurs.
- Jour 9 : corriger standards + règles + exceptions.
- Jour 10 : déployer en semi-auto + dashboard simple (temps, erreurs, incidents).
Tu veux aller vite ? Fais petit. Mais fais contrôlable. C’est ça, “déployer des agents IA en production” en entreprise.
Ce que tu fais maintenant
Tu prends tes 3 processus. Tu écris l’entrée/sortie sur une page. Tu fixes les seuils de validation. Tu mets les logs et un kill switch. Et tu lances un pilote semi-auto sur 10 jours.
Si tu dois retenir une phrase : l’agent propose, le RPA exécute, l’humain contrôle, et les logs te protègent.