Le problème en 2026 : le prix au token ne raconte plus ta facture
Tu regardes une grille “$ / 1M tokens”. Tu te dis : “OK, je compare GPT-6, Claude Opus, Mistral… et je tranche”.
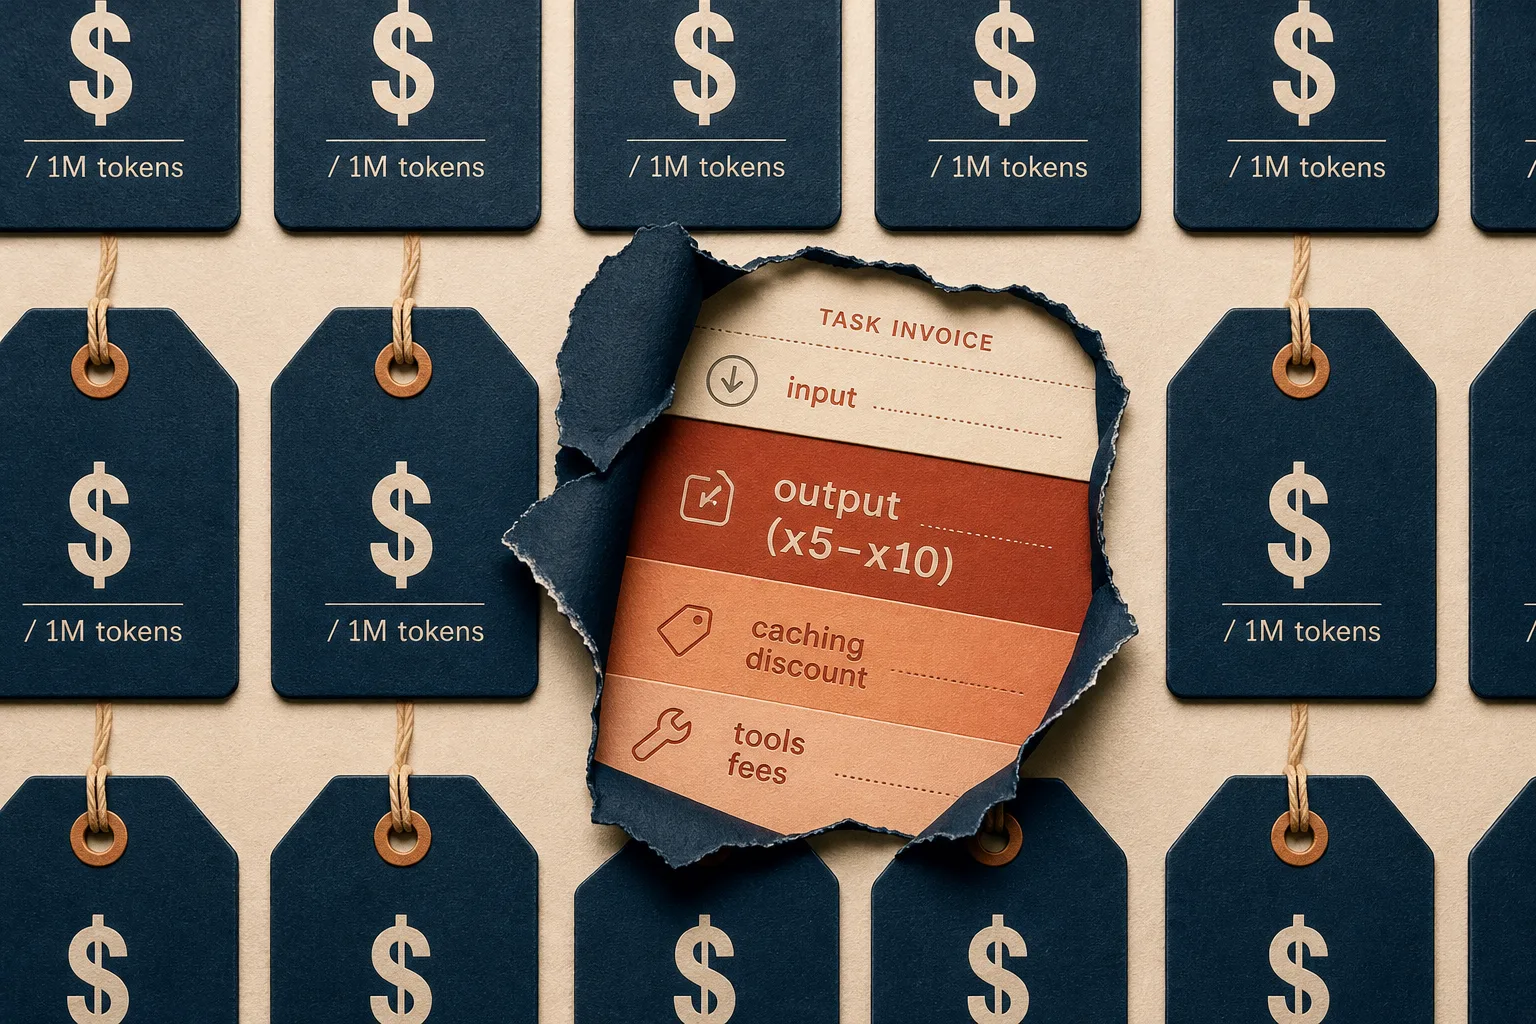
Sauf qu’en 2026, cette comparaison te plante dans 80 % des cas. Pas parce que les tarifs mentent. Parce que ta facture réelle dépend d’autres postes qui pèsent autant, voire plus :
- Output beaucoup plus cher que l’input (souvent x5 à x10). Donc une tâche “qui rédige” coûte autrement plus qu’une tâche “qui lit”.
- Caching : tu peux diviser le coût si tu réutilises un “préfixe” stable (procédures, format de réponse, extraits de politique interne). Mais tu peux aussi le rater et payer plein pot.
- Outils intégrés : recherche dans des fichiers, navigation, grounding, appels d’API, connecteurs… parfois facturés à part, parfois indirectement via plus de tokens.
- Modes de traitement : batch/flex/fast, data residency, endpoints régionaux. Ça touche directement le budget et la conformité.
Donc la bonne question n’est pas “combien coûte 1M tokens ?”. La bonne question est : combien coûte UNE tâche métier, complète, avec contrôle qualité.
Les prix 2026 à connaître (pour ton comparatif GPT-6 vs Claude Opus vs alternatives)
Tu as besoin de quelques repères de prix “list” pour alimenter ton chiffrage par tâche. Voici ceux qu’on voit en 2026 dans les grilles publiques.
OpenAI (API, $/1M tokens)
- GPT-6 Astra : 10$ input / 50$ output (standard).
- GPT-6.1 Sol : 2$ input / 10$ output.
- GPT-6 Luna : 0.10$ input / 0.50$ output.
- Cached input (ex. Sol) : 0.10$ / 1M cached input tokens.
- Cache writes : le “write” est facturé au taux input avec un multiplicateur (ex. 1.25x pour 30 min, 2.5x pour une durée plus longue selon les modalités).
- Data residency / endpoints régionaux / FedRAMP : on voit des surcoûts autour de +10% selon options et modèles.
Anthropic (Claude, $/1M tokens)
- Claude Opus 4.7 : 5$ input / 25$ output (standard global).
- US-only inference : 5.50$ input / 27.50$ output (1.1x).
- Batch (ordre de grandeur) : 2.50$ input / 12.50$ output (global batch sur Opus 4.7).
Google (Gemini) : attention aux coûts “par requête” en plus des tokens
- Le Grounding via Google Search a un modèle “requêtes” : 5 000 requêtes gratuites/mois, puis 14$ / 1 000 requêtes (sur certains plans partagés).
- Sur l’Agent Platform, tu vois apparaître des notions qui changent la donne : thinking tokens, priorité, cached, etc.
Alternative budget crédible : Mistral
- Mistral Large : 0.5$ input / 1.5$ output.
- Mistral Small 4 : 0.15$ input / 0.60$ output.
- Mistral Medium 3.5 : 1.50$ input / 7.50$ output.
Maintenant, on arrête de “comparer des tokens”. On chiffre par tâche.
La méthode “coût agent IA par tâche” (celle qui tient devant un CFO)
Objectif : transformer une tâche métier en coût complet :
- Coût modèle (input, output, cache)
- Coût outils (recherche, grounding, API, exécutions)
- Coût qualité (vérification, reprises)
- Coût des échecs (taux d’erreur x coût d’incident, quand c’est critique)
Étape 1 : décrire la tâche comme un scénario exécutable
Pas “un prompt”. Un scénario. Simple. Testable. Exemples typiques :
- Lecture + synthèse : lit 1 PDF, extrait 10 points, propose 3 décisions.
- Extraction : récupère 12 champs d’un document et les pousse dans le CRM.
- Rédaction : génère une réponse client avec ton ton, tes contraintes, et une proposition commerciale.
- Outils : va chercher dans une base interne, compare à une politique, puis crée un ticket ou un draft d’email.
Ce scénario te sert ensuite à mesurer tokens, erreurs, et temps de contrôle.
Étape 2 : mesurer 3 volumes de tokens, pas 1
- Input : données + instruction + contexte.
- Output : livrable final.
- Préfixe réutilisable (cache) : procédures, structure, règles internes, exemples stables.
En 2026, c’est le point qui fait exploser ou sauver ton budget IA entreprise. Parce que :
- l’output est cher, donc une tâche “qui parle beaucoup” est un piège,
- le cache peut rendre une tâche répétitive ridiculement moins chère… si tu l’architectures bien.
Étape 3 : chiffrer le coût de qualité (sinon ton ROI est faux)
Un agent IA sans contrôle qualité, ce n’est pas une économie. C’est un transfert de risque.
Tu choisis un mode de vérification :
- Contrôle humain systématique : tâches critiques (juridique, finance, RH, santé, sécurité).
- Contrôle par échantillonnage : tâches répétitives (support N1, tri, tagging), avec seuils et monitoring.
- LLM-as-judge + fallback humain : hybride, utile si tu as des critères objectifs.
Formule simple :
Coût vérification par tâche = (minutes de relecture x coût/min chargé) + coût des reprises.
Et tu ajoutes un “coût d’échec” si une erreur peut te coûter cher (remboursement client, pénalité, mauvaise décision). Même une estimation grossière vaut mieux que zéro.
Le calcul “par tâche” : formule et tableau type
Tu peux faire ça dans un Google Sheet en 15 minutes.
Formule
Coût complet par tâche = Coût tokens + Coût cache + Coût outils + Coût vérification + Coût échecs
Avec :
- Coût tokens = (Input_non_cache/1M x prix_input) + (Output/1M x prix_output)
- Coût cache = (Cache_hits/1M x prix_cached_input) + (Cache_writes/1M x prix_input x multiplicateur_write)
- Coût outils = (nb_requêtes_search x prix_requête) + (autres API, exécutions)
- Coût vérification = minutes_relecture x coût_minute + (taux_reprise x minutes_reprise x coût_minute)
- Coût échecs = taux_erreur_critique x coût_incident_moyen
Tableau type (exemple chiffré, à adapter)
Exemple de tâche : “Synthèse d’un dossier client + email de réponse”
- Input total : 18 000 tokens
- Dont préfixe stable cachable : 6 000 tokens
- Output : 1 200 tokens
- Cache hits : 6 000 tokens (si réutilisation)
- Cache writes : 6 000 tokens (si tu réécris le préfixe selon ta mécanique)
- Vérification : 3 min
- Coût minute chargé : 1.20€ (exemple, à recalculer chez toi)
- Taux de reprise : 20% avec +2 min
| Poste | Variables | GPT-6.1 Sol | Claude Opus 4.7 | Mistral Large |
|---|---|---|---|---|
| Input non caché | 12k tokens | 12k/1M x 2$ = 0.024$ | 12k/1M x 5$ = 0.060$ | 12k/1M x 0.5$ = 0.006$ |
| Output | 1.2k tokens | 1.2k/1M x 10$ = 0.012$ | 1.2k/1M x 25$ = 0.030$ | 1.2k/1M x 1.5$ = 0.0018$ |
| Cache hits | 6k tokens | 6k/1M x 0.10$ = 0.0006$ | (selon offre) à renseigner | (selon offre) à renseigner |
| Cache writes | 6k tokens | 6k/1M x (2$ x 1.25) = 0.015$ | (selon offre) à renseigner | (selon offre) à renseigner |
| Outils | recherche, connecteurs | 0$ à 0.XX$ | 0$ à 0.XX$ | 0$ à 0.XX$ |
| Vérification | 3 min + reprises | 3 min x 1.20€ + (0.2 x 2 min x 1.20€) = 4.08€ | ||
Lecture simple : les tokens coûtent des centimes sur beaucoup de tâches. La vérification coûte des euros. Donc ton levier numéro 1, ce n’est pas “gratter 20% sur le prix token”. C’est réduire le temps de contrôle et faire baisser le taux d’erreur sur les tâches qui tournent en volume.
Les 4 pièges qui te font choisir le mauvais modèle
Piège 1 : ignorer que l’output drive le coût
Tu compares sur l’input. Mauvais réflexe. Une tâche de rédaction (beaucoup d’output) peut coûter 5 à 10 fois plus qu’une tâche d’extraction courte, à volume égal.
Action : cappe l’output. Tu imposes un format. Tu forces une réponse courte et structurée. Tu fais produire des “blocs” réutilisables au lieu d’un roman.
Piège 2 : ne pas architecturer le cache
Si ton agent répète à chaque fois : procédures, contraintes légales, ton de marque, templates… tu repayes du token. Et tu rallonges la latence.
Action : mets en cache un “prefix” stable. Puis teste 2 scénarios :
- Sans cache (pire cas)
- Avec cache (cas réel après industrialisation)
Piège 3 : oublier le coût des outils
Un agent “qui sait chercher” coûte parfois plus via la brique search/grounding que via le modèle lui-même. Chez Google, certaines options de grounding ont un prix par requête. Et côté connecteurs, tu payes parfois à l’usage indirect (plus d’étapes, plus de tokens, plus de logs).
Action : dans ton chiffrage, ajoute une ligne “outils” dès le jour 1, même si tu mets 0 au début. Sinon tu vas “découvrir” le coût en prod.
Piège 4 : faire comme si la qualité était gratuite
Le vrai sujet ROI agent IA, c’est le taux d’erreur et le temps de vérif. Pas le modèle “le plus intelligent”.
Action : mesure un taux de reprise par tâche, et un temps moyen de relecture. Si tu ne le fais pas, tu gères au feeling, donc tu perds.
Si tu veux cadrer ce point proprement, tu peux t’appuyer sur l’idée de “taxe de vérification” : https://jimmymanin.com/blog/taxe-de-verification-eviter-que-lia-te-fasse-perdre-du-temps-pas-en-gagner
Comparer GPT-6, Claude Opus et alternatives : le protocole en 45 minutes
Tu prends 10 tâches, pas 1. Parce que chaque modèle gagne sur des profils différents.
1) Sélectionne 10 tâches représentatives
- 3 tâches lecture/synthèse
- 3 tâches extraction/structuration
- 3 tâches rédaction
- 1 tâche agent avec outils (recherche + action)
2) Pour chaque tâche, fixe 3 niveaux de criticité
- Non critique : erreur tolérable, relecture rapide.
- Importante : relecture systématique, impacts clients possibles.
- Critique : double validation, logs, traçabilité, politique de refus.
Pour les agents connectés à tes outils, ne fais pas l’impasse sur les garde-fous sécurité. Sinon ton “ROI” va finir en incident. Point de départ utile : https://jimmymanin.com/blog/agents-ia-en-entreprise-checklist-securite-en-12-points-anti-fuite-avant-deploiement
3) Mesure tokens et temps humain sur un mini-pilote
Tu lances 30 exécutions par tâche (oui, 30). Tu mesures :
- Input/output moyen
- Variance (les pires cas)
- Taux d’erreur (selon tes critères)
- Temps de relecture
4) Calcule un coût complet par tâche et par modèle
Et tu sors un coût mensuel :
Coût mensuel = coût complet par tâche x volume mensuel
Ensuite tu compares à la valeur : temps gagné, marge, réduction de backlog, réduction d’erreurs.
Si ton sujet est aussi “éviter les budgets qui dérapent”, garde un cadre de pilotage : https://jimmymanin.com/blog/budgets-ia-qui-derapent-piloter-tokens-licences-et-depassements-sans-bloquer-tes-equipes
Règle de décision simple : bon, mieux, surdimensionné
Tu veux une règle qui évite les débats sans fin. La voilà.
Bon (modèle budget, type GPT-6 Luna ou Mistral Small)
- Tâches répétitives, à faible criticité
- Output court, formats structurés
- Vérification par échantillonnage
- Objectif : coût minimum par tâche
Typique : tri d’emails, extraction simple, catégorisation, résumé court, support N1 très cadré.
Mieux (modèle équilibré, type GPT-6.1 Sol ou équivalent)
- Tâches mixtes lecture + rédaction
- Criticité moyenne
- Besoin de cohérence, bon suivi d’instructions
- Objectif : meilleur coût complet (tokens + moins de reprises)
Typique : comptes rendus, emails commerciaux, synthèses de dossier, FAQ interne, drafts de procédures.
Surdimensionné (modèle haut de gamme, type GPT-6 Astra ou Claude Opus)
- Tâches à fort risque business (décision, juridique, finance, réputation)
- Tâches où la réduction du taux d’erreur vaut plus que le coût token
- Cas complexes, multi-docs, ambiguïté forte
- Objectif : réduire la “taxe de vérification” et les incidents
Si tu utilises un modèle haut de gamme pour des tâches simples, tu payes pour rien. Si tu utilises un modèle budget sur une tâche critique, tu payes après, en temps et en emmerdes.
Le ROI : ce que tu dois vraiment mettre dans l’équation
Un calcul ROI agent IA sérieux, ce n’est pas “heures gagnées x taux horaire”. Tu ajoutes :
- Coût d’implémentation : intégration, tests, garde-fous, monitoring.
- Coût de run : tokens, outils, stockage, logs, data residency.
- Coût de contrôle : relecture, reprises, escalades.
- Coût de risque : fuites, erreurs, non-conformité, incidents clients.
Et tu compares à une valeur business : délai réduit, marge améliorée, plus de volume traité sans recruter, baisse des erreurs.
Si ton arbitrage est “IA ou embauche”, fais le calcul honnête : https://jimmymanin.com/blog/ia-ou-embauche-le-calcul-honnete-avant-de-choisir-un-logiciel-plutot-quun-salarie
Checklist actionnable : ton chiffrage “budget IA entreprise” en 60 minutes
- 1) Liste 10 tâches candidates. Choisis 3 tâches à volume, 3 à valeur, 3 à douleur, 1 agent connecté.
- 2) Pour chaque tâche : définis un livrable, un format, un cap d’output (max tokens ou max longueur).
- 3) Mesure sur 30 runs : input, output, taux de reprise, temps de relecture.
- 4) Identifie le “prefix stable” à mettre en cache (procédure + format + règles).
- 5) Ajoute la ligne “outils” même à zéro (search, grounding, connecteurs, exécutions).
- 6) Calcule le coût complet par tâche pour 3 modèles minimum : un budget, un équilibré, un premium.
- 7) Classe chaque tâche en bon / mieux / surdimensionné selon criticité et coût de vérification.
- 8) Prends une décision de dirigeant : modèle par tâche, pas un modèle unique “pour tout”.
Si tu fais une seule chose après cette lecture : arrête d’acheter “un modèle”. Achète une performance sur une tâche. Et chiffre-la au coût complet. C’est comme ça que tu compares vraiment le prix GPT-6 vs Claude Opus vs alternatives, sans te faire hypnotiser par une ligne “$/1M tokens”.