Tu veux “anonymiser” pour nourrir une IA ? Commence par arrêter de te raconter des histoires
Le scénario classique : tu veux faire du RAG sur des tickets support, entraîner un modèle sur des dossiers clients, ou juste faire de l’analytics avec un LLM. Quelqu’un dit “on anonymise”, on supprime les noms, on remplace par des ID, et on envoie ça au prestataire.
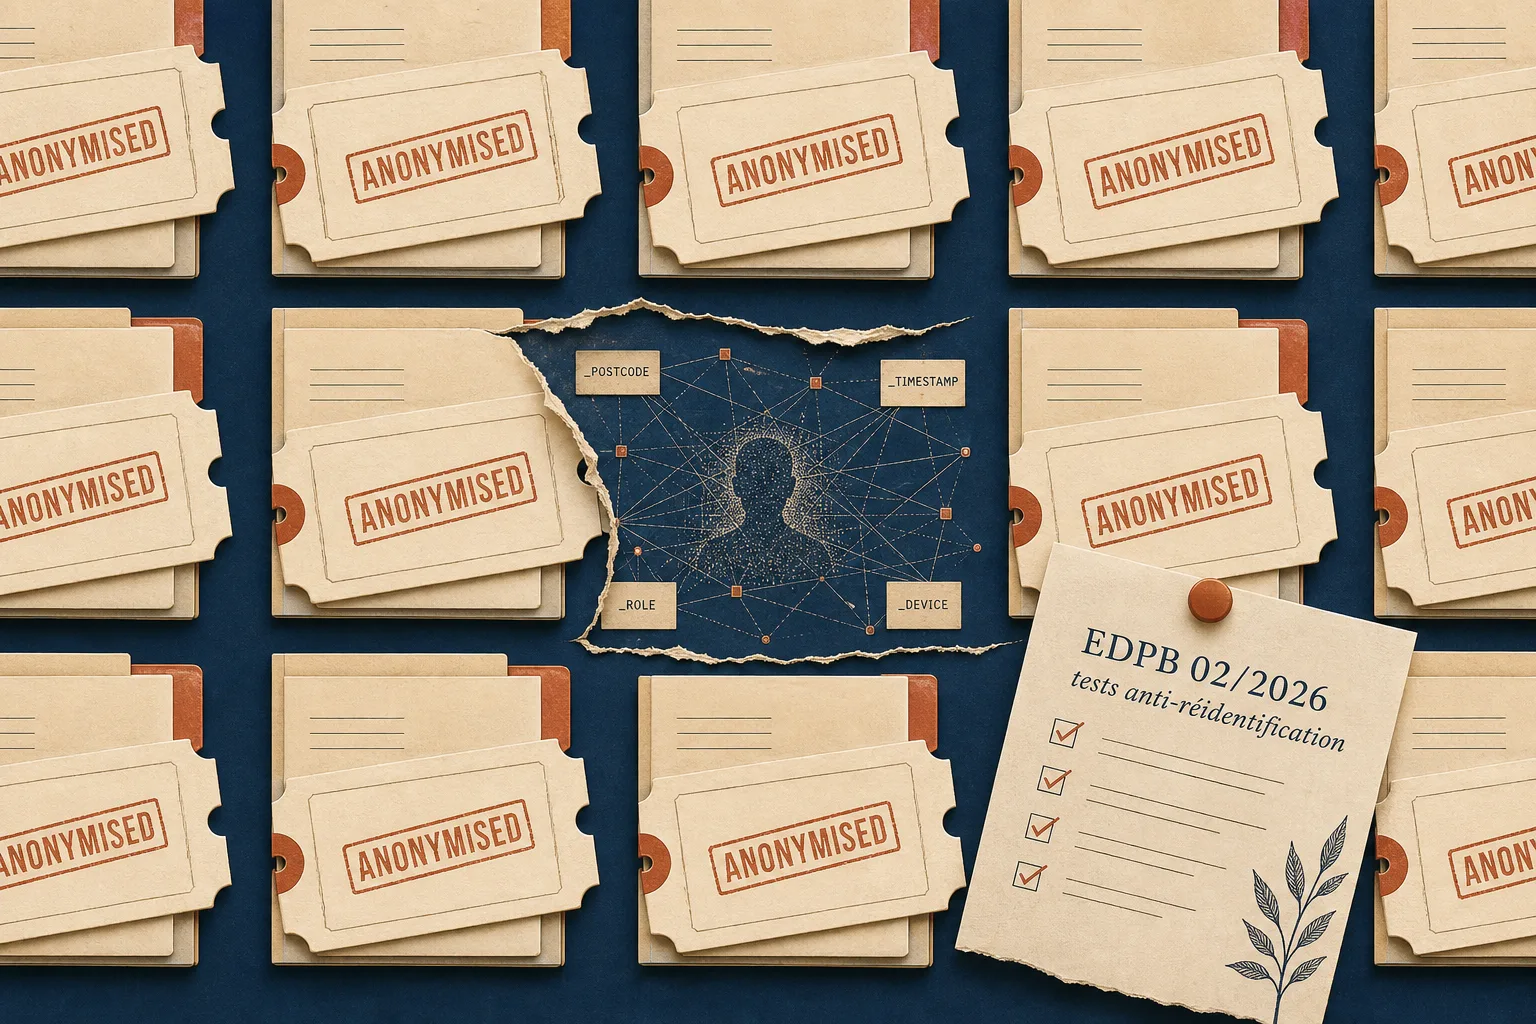
Sauf que ça, dans la vraie vie, c’est souvent de la pseudonymisation. Pas de l’anonymisation. Et le jour où ça fuite ou que la CNIL demande “prouve-moi que c’est anonyme”, tu n’as rien. Juste une intuition.
Bonne nouvelle : l’EDPB (Comité européen de la protection des données) a publié un projet de Guidelines 02/2026 on Anonymisation (adopté le 7 juillet 2026, consultation ouverte du 8 juillet au 30 octobre 2026). Ils mettent à jour l’Opinion 05/2014 du G29. Et surtout, ils poussent un angle très “terrain” : l’anonymat n’est pas un label. Ça s’évalue par destinataire et par perspective.
Objectif de cet article : te donner un protocole dirigeant en 60 à 120 minutes pour qualifier tes données, choisir une stratégie, et surtout documenter des tests de ré-identification. Avec 3 livrables concrets :
- une fiche dataset (finalité, risques, accès)
- un plan de tests anti-réidentification
- une matrice “peut / pas peut” pour tes usages IA (RAG, entraînement, analytics)
1) Le point clé EDPB 2026 : “anonyme pour qui ?”
L’EDPB insiste : une même donnée peut être anonyme pour un tiers et rester personnelle pour toi (ou ton prestataire), selon les moyens “raisonnablement susceptibles d’être utilisés” pour ré-identifier.
Deux approches possibles (tu choisis ta gouvernance)
- Approche contextuelle : tu évalues les moyens réels des acteurs (tes équipes, ton sous-traitant, un attaquant réaliste). C’est souvent plus juste, mais ça demande de documenter tes hypothèses.
- Approche simplifiée : tu es volontairement conservateur. Si un doute sérieux existe, tu traites comme non-anonyme. C’est plus “safe” en gouvernance, parfois plus coûteux, mais plus simple à expliquer au board.
Décision dirigeant à prendre tout de suite
Tu veux optimiser (contextuel) ou sécuriser (simplifié) ? Si tu externalises beaucoup (LLM, intégrateur, data platform), l’approche simplifiée te fait souvent gagner du temps politique et juridique.
2) Données anonymes vs pseudonymes : le test qui évite 80% des erreurs
Version cash :
- Pseudonyme : tu as remplacé des identifiants (nom, email) mais quelqu’un peut encore relier à une personne avec une clé, un autre fichier, ou des recoupements.
- Anonyme : la personne n’est pas identifiable avec des moyens raisonnables, compte tenu du contexte.
Donc retirer “Nom / Prénom” ne suffit pas. Même “hachage de l’email” ne suffit pas si tu as une table de correspondance, ou si l’attaquant peut recalculer le hash.
Checklist express “tu es encore en perso”
- Tu gardes un identifiant stable (même pseudonyme) qui suit la personne dans le temps.
- Tu as des variables très précises : date/heure au minute près, code postal, âge exact, montant exact, intitulés libres (commentaires, motifs, emails).
- Tu travailles au niveau record (ligne par ligne) avec beaucoup de colonnes. L’EDPB le dit : forte dimension + forte résolution = ré-identification plus probable.
3) La fiche “dataset” (livrable 1) : 1 page, pas un roman
Avant de parler technique, tu cadres. Une anonymisation sans fiche dataset, c’est comme un contrat sans objet.
Template de fiche dataset (copie-colle)
- Nom du dataset : ex. “Tickets support 2024-2026”
- Finalité : ex. “RAG pour assistant support interne” ou “analytics qualité”
- Usage IA visé : RAG, entraînement/fine-tuning, BI/analytics, évaluation, tests
- Destinataires (par entité) : interne, intégrateur, éditeur LLM, hébergeur, partenaire
- Où ça tourne : poste local, cloud UE, SaaS US, environnement isolé
- Accès : qui peut lire, exporter, croiser, télécharger
- Données directes : noms, emails, numéros client, téléphone, IBAN
- Quasi-identifiants : date/heure, géoloc, poste, fonction, site, raretés
- Données sensibles / à fort impact : santé, RH, sanctions, plaintes, finance perso
- Données auxiliaires disponibles : CRM, annuaires, open data, logs, fuites possibles
- Durée de conservation : brute et “anonymisée”
- Risque business : impact si ré-identification (juridique, réputation, clients)
- Décision : “Anonyme pour X”, “Pseudonyme pour Y”, “Interdit hors périmètre”
4) Les 3 axes de tests anti-réidentification (EDPB) : ton plan de preuve
L’EDPB propose 3 critères techniques. Tu dois les traduire en tests. Pas forcément des tests universitaires. Des tests réalistes, reproductibles, documentés.
Axe 1 : No Record Isolation (impossible d’isoler un individu)
Question simple : est-ce qu’on peut pointer “la ligne de Jean Dupont” ? Même sans son nom.
- Risque typique : une combinaison rare (site + date + produit + incident) identifie quelqu’un.
- Symptôme : tu as des identifiants stables, ou des événements uniques.
Axe 2 : No Linkage (impossible de relier à d’autres données)
Question simple : est-ce qu’en croisant avec un autre fichier on retrouve la personne ?
- Exemples de fichiers “auxiliaires” : CRM, LinkedIn, open data (dirigeants, professions réglementées), annuaires internes, fuites historiques, exports Excel qui traînent.
- Ce test casse la majorité des “anonymisations” naïves.
Axe 3 : No Inference (impossible d’inférer des infos sur un individu)
Question simple : même sans identifier, est-ce qu’on peut déduire un attribut sensible sur une personne ciblée ? Exemple : “ce salarié a eu un arrêt”, “ce client est en litige”, “ce médecin prescrit X”.
Ce point est crucial avec l’IA, parce qu’un LLM est un moteur d’inférence. Tu lui donnes des patterns, il généralise.
5) Choisir ta stratégie d’anonymisation : 5 options (et leurs limites)
Il n’y a pas une “bonne” méthode. Il y a un compromis : utilité business vs risque de ré-identification vs coût.
Option A : Suppression (suppression pure)
Tu vires des colonnes (identifiants + quasi-identifiants à risque).
- Avantage : simple, rapide, efficace.
- Limite : tu perds des variables utiles (contexte, segmentation, chronologie).
- Bon fit : analytics grossier, reporting, QA.
Option B : Agrégation (k-anonymity “terrain”)
Tu passes du record au groupe : par semaine au lieu de par jour, par zone au lieu d’adresse, par tranche d’âge au lieu d’âge exact.
- Avantage : tu gardes de la valeur pour piloter.
- Limite : RAG et cas individuels deviennent moins bons.
- Bon fit : dashboards, tendances, pilotage dirigeant.
Option C : Données synthétiques
Tu génères des données “ressemblantes” au lieu de partager les vraies.
- Avantage : top pour dev, tests, démos, prototypage IA.
- Limite : si c’est mal fait, tu peux régurgiter des points trop proches du réel. Et tu peux perdre des corrélations utiles.
- Bon fit : POC, évaluation de modèles, entraînement “safe-ish” (à tester, pas à croire).
Option D : Tokenisation / remplacement (pseudonymisation)
Tu remplaces nom, email, numéro client par des tokens.
- Avantage : tu gardes la structure relationnelle (même client sur plusieurs lignes).
- Limite : ce n’est pas de l’anonymisation si quelqu’un peut relier ou si les quasi-identifiants restent.
- Bon fit : traitement interne, environnements contrôlés, besoins métier nécessitant le suivi.
Option E : Masquage “intelligent” de texte (PII scrubbing)
Tu as des champs libres (emails, notes, comptes rendus). Tu dois détecter et masquer noms, adresses, numéros, mais aussi des indices contextuels.
- Avantage : indispensable pour RAG sur documents.
- Limite : faux négatifs garantis. Et l’IA peut ré-introduire du contexte (“le maire de X”) même si le nom est masqué.
6) Le plan de tests anti-réidentification (livrable 2) : simple, méchant, documenté
Tu veux pouvoir dire : “voilà nos hypothèses, voilà nos tests, voilà nos résultats, voilà notre décision”. Même si ce n’est pas parfait. C’est ça, une posture de dirigeant.
Étape 1 : définis l’attaquant (par destinataire)
- Interne : accès à CRM + logs + connaissance métier.
- Sous-traitant : accès au dataset + à ce que tu lui donnes, pas au CRM (normalement).
- Éditeur LLM : dépend du contrat et des réglages (conservation, entraînement, logging).
- Attaquant externe : open data + réseaux sociaux + données achetées.
Étape 2 : teste No Record Isolation (3 tests)
- Test unicité : cherche des combinaisons uniques (ex. site + date + produit + incident). Si tu en trouves, tu as un problème.
- Test “cas rare” : prends 20 cas atypiques (gros montant, incident unique, profession rare) et vois si on peut les isoler.
- Test stabilité : est-ce qu’un token suit une personne dans le temps et rend le profil traçable ?
Étape 3 : teste No Linkage (4 tests)
- Cross-check CRM (interne uniquement) : tente de relier via dates, lieux, montants, intitulés.
- Cross-check open data : dirigeants, professions publiques, marchés publics, annuaires.
- Test “fuite plausible” : imagine qu’un export Excel historique fuite. Est-ce que tu peux relier ?
- Test “partenaire” : un partenaire qui connaît déjà certains clients peut-il les retrouver dans le dataset ?
Étape 4 : teste No Inference (3 tests)
- Attribut sensible : est-ce qu’on peut inférer santé, RH, litige, fragilité financière, orientation, etc. à partir des patterns ?
- Test de ciblage : en partant d’une personne connue (ex. “le seul médecin de telle commune”), peut-on inférer son comportement dans le dataset ?
- Test IA : tu fais résumer/classer par un LLM et tu vérifies si des détails permettent de deviner qui c’est (même si le nom n’apparaît pas).
Étape 5 : documente (sinon ça n’existe pas)
- Hypothèses : qui attaque, avec quels moyens, quelles données auxiliaires.
- Jeux de tests : échantillons, critères, scripts ou requêtes.
- Résultats : taux d’unicité, exemples de ré-identification réussie, mesures correctives.
- Décision : anonyme/perso selon destinataire, et usages autorisés.
- Date de prochaine revue : l’EDPB recommande la réévaluation périodique. Mets-la dans le calendrier.
7) Matrice “peut / pas peut” pour les usages IA (livrable 3)
Tu veux éviter le flou. Tu poses une règle simple : un dataset n’est pas “OK IA” en général. Il est OK pour un usage, un destinataire, un contexte.
Exemple de matrice (à adapter)
- RAG interne :
- Peut : pseudonymisé + contrôle d’accès strict + pas d’export + logs + rétention courte.
- Pas peut : données RH/santé en texte libre sans scrubbing solide.
- RAG chez un prestataire / SaaS :
- Peut : agrégé ou fortement minimisé, ou synthétique pour POC.
- Pas peut : record-level riche (forte dimension/résolution) même “sans noms”.
- Entraînement / fine-tuning :
- Peut : données vraiment anonymes (testées) ou synthétiques validées.
- Pas peut : pseudonymisé “à la va-vite”. Trop de risque de mémorisation et de ré-identification indirecte.
- Analytics / BI avec LLM :
- Peut : agrégation + suppression des rares + réduction de précision.
- Pas peut : granularité individuelle si ça sort de ton SI contrôlé.
8) Les 7 pièges qui te font perdre du temps, de l’argent, ou un audit
- Confondre anonymisation et pseudonymisation : classique, destructeur.
- Oublier les données auxiliaires : CRM, open data, logs. Donc échec No Linkage.
- Garder trop de précision : timestamps exacts, localisations fines, montants exacts. Donc isolement.
- Partager du record-level “riche” : forte dimension + forte résolution. L’EDPB cible explicitement ce cas.
- Ne pas tester le texte libre : c’est là que tout fuit.
- Ne pas documenter : sans preuve, tu es en opinion, pas en conformité.
- Penser que c’est “fait une fois pour toutes” : les moyens évoluent, donc tu dois requalifier périodiquement.
9) Protocole 90 minutes : ce que tu fais cette semaine
Bloc 1 (20 min) : fiche dataset
Tu remplis la fiche 1 page. Tu identifies destinataires et usage IA. Tu notes les données auxiliaires évidentes.
Bloc 2 (30 min) : matrice “anonyme pour qui”
Tu fais 4 colonnes : interne, prestataire, éditeur LLM, externe. Pour chaque, tu listes “moyens réalistes” et “accès”. Tu choisis approche contextuelle ou simplifiée.
Bloc 3 (30 min) : plan de tests
Tu écris les tests No Record Isolation / No Linkage / No Inference. Même si c’est juste des requêtes SQL + un test IA sur 50 exemples.
Bloc 4 (10 min) : matrice “peut / pas peut”
Tu tranches : RAG interne OK sous conditions, entraînement interdit, analytics agrégé OK, etc. Tu mets une date de revue (ex. tous les 6 ou 12 mois).
Tu veux un garde-fou simple : traite “anonymisé” comme “à prouver”, pas comme “à déclarer”
Si tu dois retenir une phrase : l’anonymisation RGPD en contexte IA, c’est un dossier de preuves. Pas un filtre magique.
Ton job de dirigeant, ce n’est pas de connaître toutes les techniques. C’est d’exiger 3 choses : une fiche dataset claire, un plan de tests anti-réidentification, et une matrice d’usages “peut/pas peut”.
Et si tu veux remettre de l’ordre côté gouvernance IA (qui fait quoi, quels contrôles, quels livrables), cale ça avec ton dispositif “privacy ops” : https://jimmymanin.com/blog/ai-act-x-rgpd-organise-tes-privacy-ops-ia-en-30-jours-et-evite-la-sanction-cnil