Le problème n’est pas l’IA. C’est le moment où tu la crois sur parole.
Tu l’as déjà vu. Tu demandes à ChatGPT ou Gemini un récap des KPI du mois. Il te sort un tableau propre, des tendances “logiques”, des explications qui sonnent vrai. Et puis tu tombes sur un chiffre qui cloche. Tu cherches la source. Il n’y en a pas. Ou pire: il t’en invente une.
Ce n’est pas un détail. Un seul KPI faux peut te faire:
- couper un budget qui marchait,
- pousser une promo inutile,
- recruter trop tôt,
- rater un signal de trésorerie,
- perdre 2 heures de réunion à débattre d’un chiffre “bizarre”.
Les modèles LLM se trompent sur les chiffres. Google le dit explicitement pour Gemini: il “peut parfois produire des informations inexactes”. OpenAI dit pareil pour ChatGPT: il peut être inexact, et recommande d’utiliser des outils de calcul (Data analysis / code interpreter) pour fiabiliser les calculs. Traduction dirigeant: si tu laisses un LLM faire ton reporting sans obligation de preuve, tu fabriques du risque décisionnel.
Et ce risque se propage. Une erreur au début devient une “boule de neige”: le modèle construit un raisonnement sur une base fausse, puis renforce l’erreur avec des explications plausibles. C’est exactement le genre d’erreur qui coûte cher, parce qu’elle a l’air crédible.
Objectif ici: fiabiliser reporting avec IA sans transformer tes équipes en contrôleurs de gestion. Tu vas poser un protocole simple, répétable, contrôlable. 5 règles. Et une checklist prête à copier pour finance, commerce, marketing.
Pourquoi ChatGPT et Gemini sortent des chiffres faux (même avec tes documents)
Tu peux donner un PDF, un export CRM, un Excel, un deck de board. Et malgré ça, tu obtiens des hallucinations chiffres LLM. Les causes les plus fréquentes en entreprise:
- Mauvais document: il pioche dans le deck au lieu de l’export source, ou dans une version N-1.
- Mauvais onglet / mauvaise colonne: un “Total” au lieu d’un “Total France”, un “Forecast” au lieu du “Réalisé”.
- Définition KPI non verrouillée: “CA” commandé vs facturé vs encaissé. “Marge” brute vs contributive.
- Unités et périmètres mélangés: € vs k€ vs M€. % vs points de %. Mensuel vs cumul vs YTD. Groupe vs filiale.
- Donnée manquante: le modèle est incité à répondre quand même, donc il “comble”.
Et il y a un piège vicieux: même quand il met des “sources”, elles peuvent être mal attribuées, ou carrément inventées. Des travaux montrent des références “hallucinées” dans une part non négligeable des citations que le modèle affirme réelles. Si tu ne forces pas la preuve, tu invites le modèle à improviser.
Dernier point: les taux d’erreur varient selon la tâche. Dans des benchmarks, tu verras des chiffres bas. Mais en “vraie vie”, multi-documents, définitions floues, exports sales, ça casse vite. Même 4% d’erreurs sur des extractions numériques (ordre de grandeur observé dans certains contextes) suffit à fausser des arbitrages.
Le protocole “reporting fiable” en 5 règles
Ce protocole sert à une chose: tu accélères la production, mais tu ne délègues pas la responsabilité de la donnée. L’IA prépare. La vérité vient des pièces justificatives.
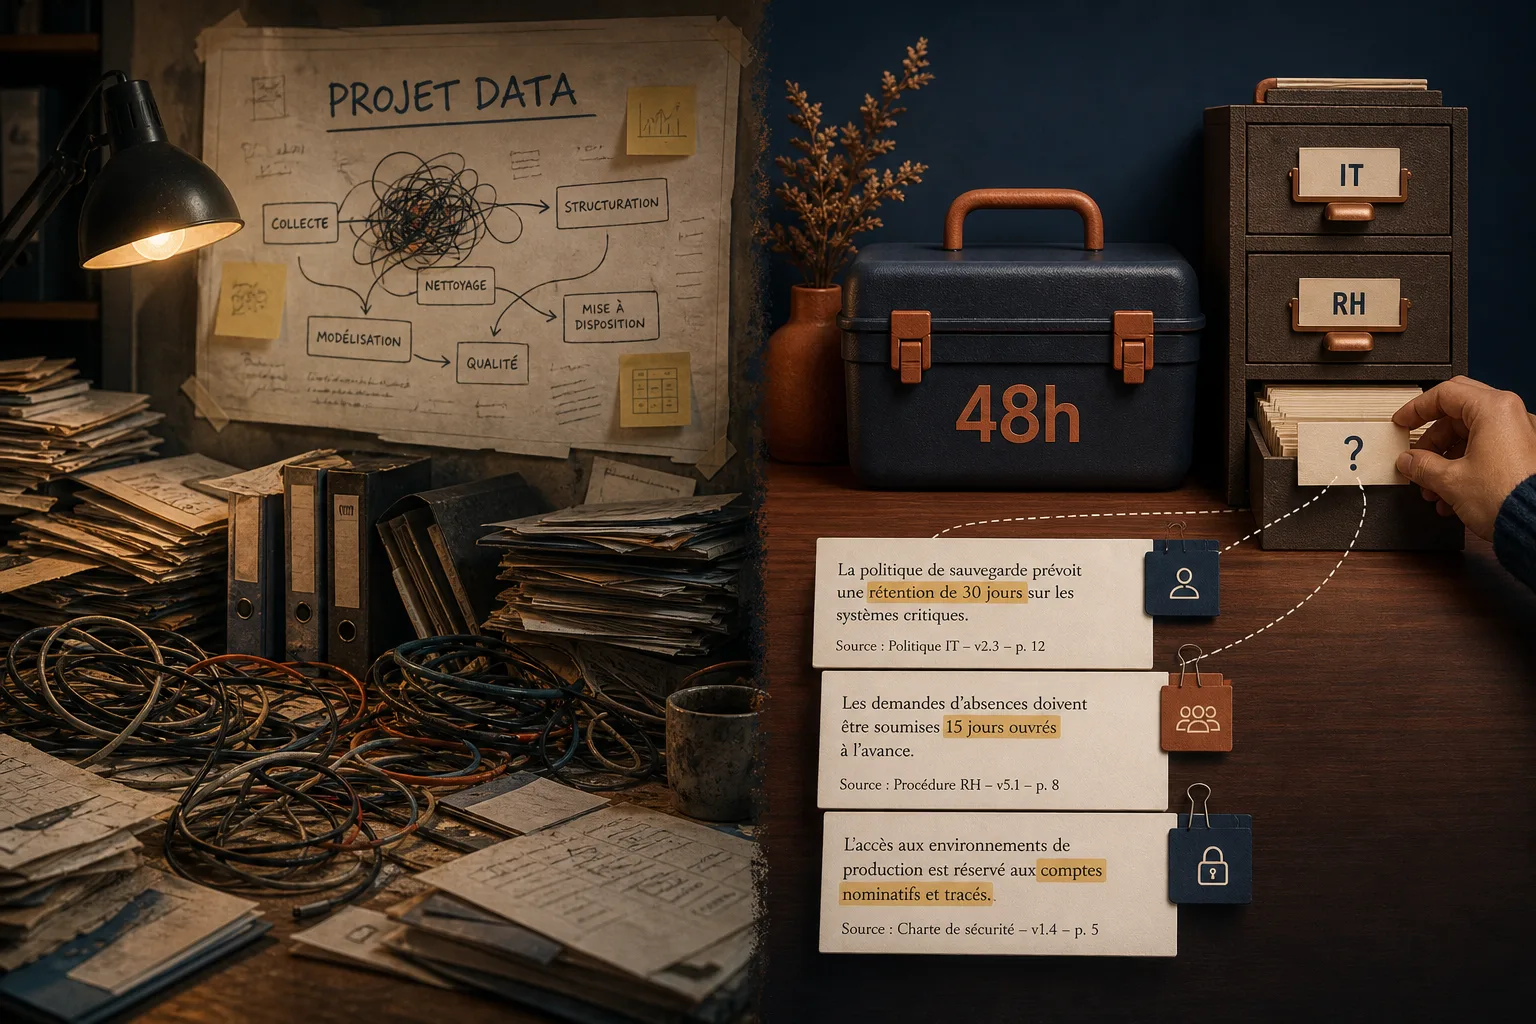
Règle 1: Sourcing obligatoire (lien + extrait, sinon le chiffre n’existe pas)
Chaque chiffre doit venir avec une preuve inspectable. Pas une phrase. Une preuve.
- Référence source: nom du fichier, version/date, onglet, cellule ou plage si possible.
- Extrait: copier-coller du tableau source (ou capture), incluant l’en-tête et l’unité.
Tu fais simple: si l’IA ne fournit pas “source + extrait”, le chiffre est marqué NON VALIDÉ.
Pourquoi c’est non négociable: OpenAI rappelle que ChatGPT peut être inexact. Donc tu changes la règle du jeu: pas de preuve, pas de KPI.
Prompt opérationnel à donner à tes équipes:
“Pour chaque chiffre, fournis: (1) source exacte (fichier + date/version + onglet + cellule/ligne), (2) un extrait copié-collé contenant ce chiffre et son en-tête, (3) l’unité et le périmètre. Si tu n’as pas les 3, écris ‘INCONNU’.”
Règle 2: Extraction structurée d’abord (table), narration ensuite
Le texte masque l’incertitude. Une table l’expose.
Tu imposes une table normalisée. Exemple:
- Indicateur
- Valeur
- Période
- Périmètre
- Unité
- Définition
- Source (fichier/onglet/cellule)
- Extrait preuve
- Statut: Validé / À vérifier / Inconnu
Une fois la table figée, tu demandes la synthèse narrative: “explique les variations, propose 3 actions”. Pas avant.
Bonus dirigeant: cette table devient ton “contrat” entre équipes. Moins d’aller-retours. Moins de réunions de clarification.
Règle 3: Validation croisée (2 sources, ou 1 source + recalcul indépendant)
Un chiffre important ne se valide pas avec “ça a l’air plausible”. Tu veux une redondance minimale.
Deux options, selon les cas:
- 2 sources indépendantes: CRM vs facturation, Ads manager vs Analytics, compta vs export ERP.
- 1 source + recalcul: total = somme de lignes, marge = (CA - coût) recalculé, taux = numérateur/dénominateur recalculé.
Et tu rends visible la validation: une colonne “Validation croisée” avec “OK / KO / Non possible”.
Pourquoi: l’erreur “boule de neige” est réelle. Si le modèle se trompe au départ, tout le storytelling derrière est faux. La validation croisée coupe le problème tôt.
Astuce simple: pour les calculs, pousse l’outil vers un mode calculateur. OpenAI souligne que “Data analysis / code interpreter” améliore l’exactitude des calculs. Traduction: tu fais faire les maths à un moteur de calcul, pas au blabla du modèle.
Règle 4: Unités et périmètres explicités (sinon stop)
Le piège numéro 1 en reporting, ce n’est pas “2 + 2”. C’est “2 quoi”.
Tu forces l’IA (et l’humain) à déclarer:
- Unité: € / k€ / M€ / % / points de % / jours / mois.
- HT ou TTC.
- Période: Mois, MTD, YTD, rolling 12, trimestre.
- Périmètre: société X, groupe, France, Europe, canal payant uniquement, etc.
- Définition KPI: CA facturé, CA encaissé, pipeline weighted, etc.
Et tu ajoutes une règle de gouvernance simple: si unité ou périmètre manquent, le chiffre passe en “À vérifier” automatiquement. Pas de discussion.
Pourquoi: les LLM “harmonisent” parfois sans te le dire. Ils convertissent, ils arrondissent, ils “normalisent”. Ça te donne un joli tableau, mais pas un tableau fiable.
Règle 5: Stop conditions (quand tu repasses en manuel)
Si tu veux un reporting fiable, tu dois définir quand l’IA n’a pas le droit d’insister.
Voici des “stop conditions” simples, orientées dirigeant:
- Stop 1: l’IA ne peut pas fournir “source + extrait” pour un KPI critique.
- Stop 2: divergence entre deux sources, écart non expliqué.
- Stop 3: unité ou périmètre ambigu (HT/TTC, groupe/filiale, cumul/mensuel).
- Stop 4: KPI “board-level” (trésorerie, marge, CA, churn, CAC) utilisé pour une décision engageante.
- Stop 5: documents trop sales (exports incomplets, colonnes non nommées, dates incohérentes).
Quand une stop condition déclenche: recherche manuelle ou recalcul dans le fichier source, puis on revient vers l’IA pour la mise en forme et l’analyse.
Tu protèges le seul truc qui compte: la décision.
Comment l’appliquer sans te rajouter une “taxe de vérification”
Le risque, c’est de perdre le temps gagné à tout contrôler. Le but, c’est l’inverse.
Donc tu cadres:
- Tu ne vérifies pas tout: tu vérifies ce qui déclenche une décision.
- Tu standardises: mêmes colonnes, mêmes statuts, même checklist.
- Tu verrouilles les sources: une hiérarchie officielle (ex: “compta fait foi”, “CRM fait foi pour pipeline”, etc.).
- Tu demandes l’abstention: “INCONNU” est une réponse correcte. Tu préfères un trou qu’un chiffre faux.
Si tu veux creuser le coût caché de la vérification et comment l’éviter: https://jimmymanin.com/blog/taxe-de-verification-eviter-que-lia-te-fasse-perdre-du-temps-pas-en-gagner
Checklist “reporting fiable” prête à copier (finance, commerce, marketing)
Copie-colle ça dans ton Notion, ton template de reporting, ou directement dans le prompt de ton équipe.
Checklist commune (obligatoire pour tous)
- 1) Objectif: à quoi sert ce reporting, quelle décision il doit permettre (budget, pricing, embauche, arbitrage)?
- 2) Source officielle par KPI: qui fait foi (compta, CRM, Ads, Analytics, outil support)?
- 3) Pour chaque chiffre: source exacte + extrait preuve (table/ligne) + unité + périmètre.
- 4) Extraction en table d’abord: aucun commentaire avant la table normalisée.
- 5) Validation croisée: 2 sources ou 1 source + recalcul.
- 6) Contrôle unités/périmètres: HT/TTC, € vs k€, mensuel vs cumul, France vs monde.
- 7) Statut: Validé / À vérifier / Inconnu (pas de “à peu près”).
- 8) Stop conditions: si déclenché, retour manuel sur source, puis reprise.
- 9) Log des hypothèses: tout ce qui n’est pas dans la source est une hypothèse, donc listé.
- 10) Versioning: date de snapshot des exports + nommage standard.
Checklist finance (mensuel, trésorerie, marge)
- CA: commandé vs facturé vs encaissé (tu choisis, tu écris la définition).
- Marge: brute vs contributive, et ce qui est inclus/exclu (frais variables, remises, sous-traitance).
- Trésorerie: solde banque + dettes court terme + encaissements attendus (périmètre clair).
- HT/TTC: verrouillé partout.
- Stop condition: tout KPI utilisé pour décider un recrutement, un investissement, un dividende.
Checklist commerce (pipeline, conversion, prévision)
- Pipeline: weighted ou non weighted, et règles de pondération.
- Étapes: définition des stages (SQL, proposition, négo) figée.
- Période: created date vs close date (tu choisis, tu assumes).
- Doublons: contrôle minimal sur comptes/opportunités dupliquées.
- Stop condition: écart entre forecast et réalisé sans explication sourcée.
Checklist marketing (spend, leads, CAC, attribution)
- Spend: source unique (Ads Manager), devise et période identiques.
- Leads: définition “lead” (form, call, MQL), dédoublonnage.
- CAC: formule écrite (spend / clients) et fenêtre temporelle (ex: 30 jours, cohorte).
- Attribution: modèle (last click, data-driven) déclaré, sinon “non comparable”.
- Stop condition: si Ads dit X et Analytics dit Y, on ne “moyenne” pas. On explique.
Le prompt “Reporting fiable” (à donner tel quel à ChatGPT ou Gemini)
“Tu es mon assistant reporting. Tu n’as pas le droit d’inventer des chiffres ni des sources.
1) Commence par produire une table avec les colonnes: Indicateur | Valeur | Période | Périmètre | Unité | Définition | Source (fichier+date+onglet+cellule/ligne) | Extrait preuve | Validation croisée (OK/KO/NA) | Statut (Validé/À vérifier/Inconnu).
2) Règle de preuve: si tu ne peux pas fournir Source + Extrait preuve, tu écris Inconnu (pas d’estimation).
3) Règle unités/périmètres: si unité, HT/TTC, période ou périmètre sont ambigus, Statut = À vérifier.
4) Après la table seulement, écris une synthèse en 10 lignes max avec: 3 variations clés, 3 causes possibles, 3 actions. Toute cause doit référencer un indicateur de la table.”
Ce que tu gagnes, concrètement
- Moins de rework: tu coupes les allers-retours “c’est quoi la source de ce chiffre”.
- Moins de réunions stériles: tu parles décisions, pas débats sur la donnée.
- Moins de risque: tu évites la décision “vite” sur un chiffre faux qui a l’air propre.
- Plus de vitesse: l’IA sert à préparer, structurer, expliquer. Pas à improviser.
Plan d’action 30 minutes (pour l’appliquer dès aujourd’hui)
- 10 min: liste tes 10 KPI “board-level” (ceux qui déclenchent une décision).
- 10 min: pour chaque KPI, écris: source officielle + définition + unité + périmètre.
- 10 min: impose la table normalisée + les statuts + les stop conditions dans ton template mensuel.
Ensuite seulement, tu laisses ChatGPT ou Gemini accélérer la mise en forme et l’analyse. Pas l’inverse.