Un agent “always-on”, ce n’est pas un chatbot. C’est un collaborateur avec des accès.
Jusqu’ici, l’IA en entreprise, c’était surtout “je pose une question, elle répond”. Avec les agents always-on type OpenAI Dots, tu passes à autre chose : un système qui continue à bosser entre deux conversations, avec sa mémoire, son ordinateur cloud, et des connexions d’apps (Drive, Notion, CRM, etc.) que tu actives.
Et là, la question dirigeant n’est plus “est-ce que la réponse est bonne ?”. C’est : qu’est-ce qu’il peut faire sans toi, avec quels accès, et comment tu prouves ce qui s’est passé si ça dérape (incident, fuite, action non voulue).
Ce papier te donne un protocole simple : 9 règles pour cadrer la délégation à un agent always-on sans créer un nouveau trou de sécurité. Avec un mini-cahier des charges et une checklist pour un déploiement en 2 semaines sur un périmètre faible risque (veille, préparation de reporting).
OpenAI Dots : ce qui change concrètement (et pourquoi ça inquiète la sécu)
OpenAI Dots (annonce DevDay 2026, rollout à partir du 29 septembre 2026, avec des restrictions géographiques annoncées) : ce sont des agents persistants dans ChatGPT. Un “dot” a :
- Un mode de travail continu : il avance même quand tu n’es pas en train de chatter.
- Un ordinateur dans le cloud : il peut naviguer, manipuler des interfaces, exécuter des actions dans des apps connectées.
- De la mémoire : il conserve du contexte (donc aussi des risques si tu laisses entrer des infos sensibles).
- Des connexions d’apps et permissions : tu choisis les outils, et tu peux définir des règles (autoriser, exiger approbation, bloquer).
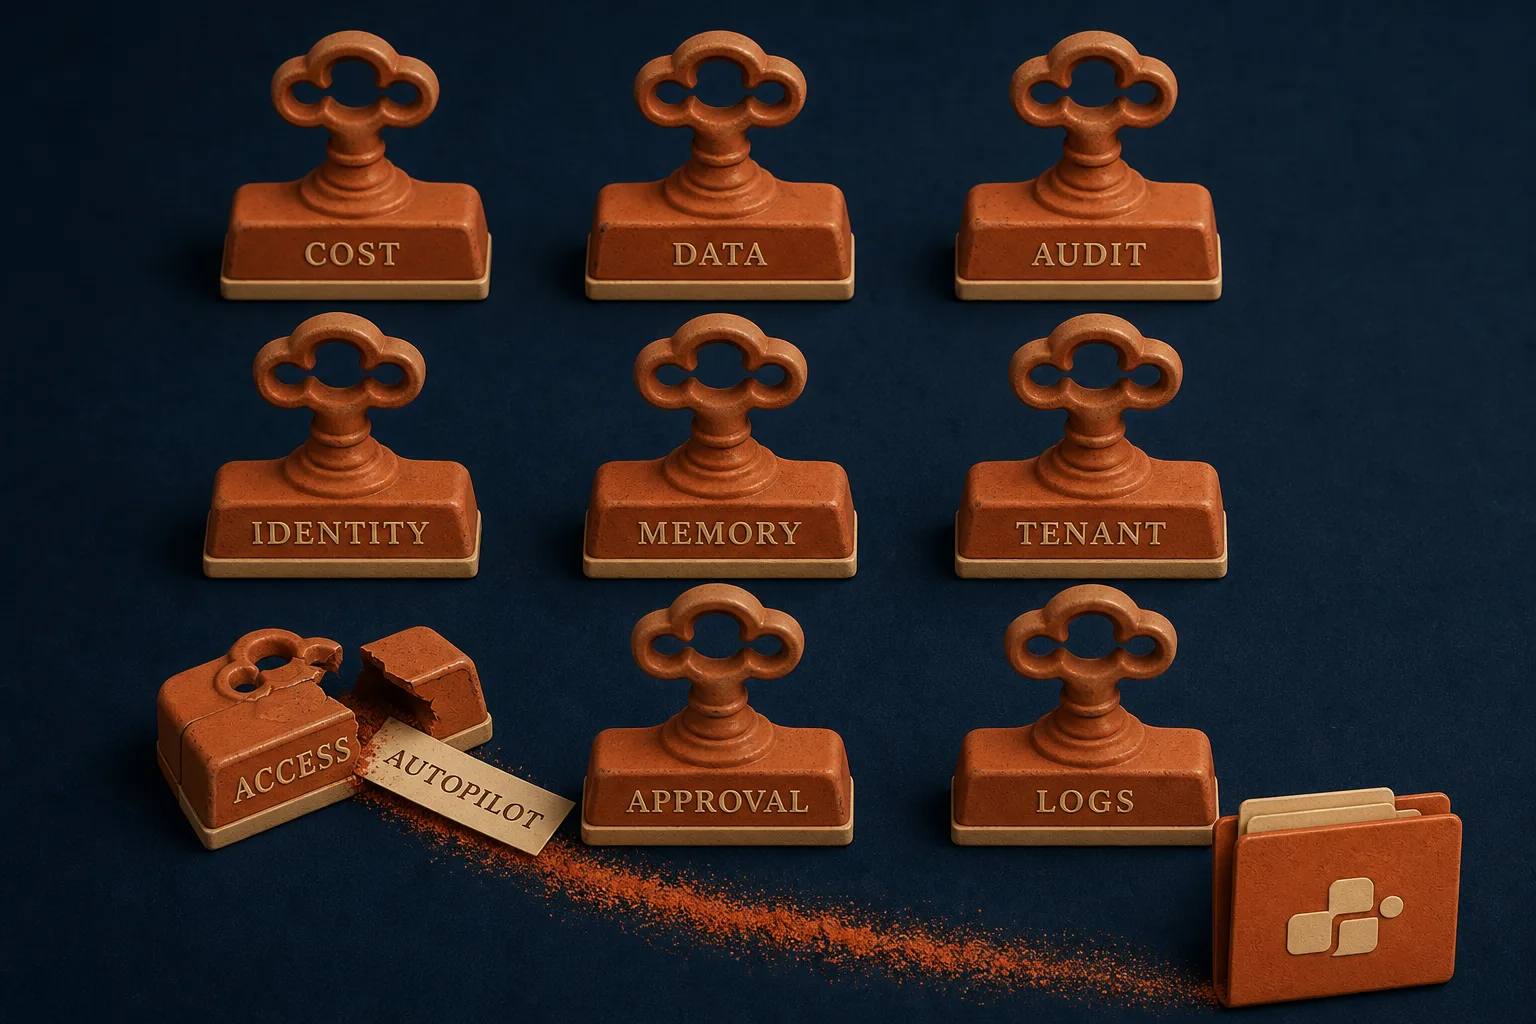
Pour une entreprise, ça veut dire une chose : tu dois traiter ça comme un système opérationnel, pas comme un jouet. Gouvernance, permissions, logs, approbations, gestion d’incident. Sinon, tu vas droit vers le combo classique : scope creep (on connecte “juste pour tester” l’email, le drive, le CRM) + effets de bord (actions non voulues) + absence de preuve (pas de traces exploitables).
Les 5 risques réels à anticiper (pas théoriques)
1) Scope creep : l’agent finit avec trop d’accès
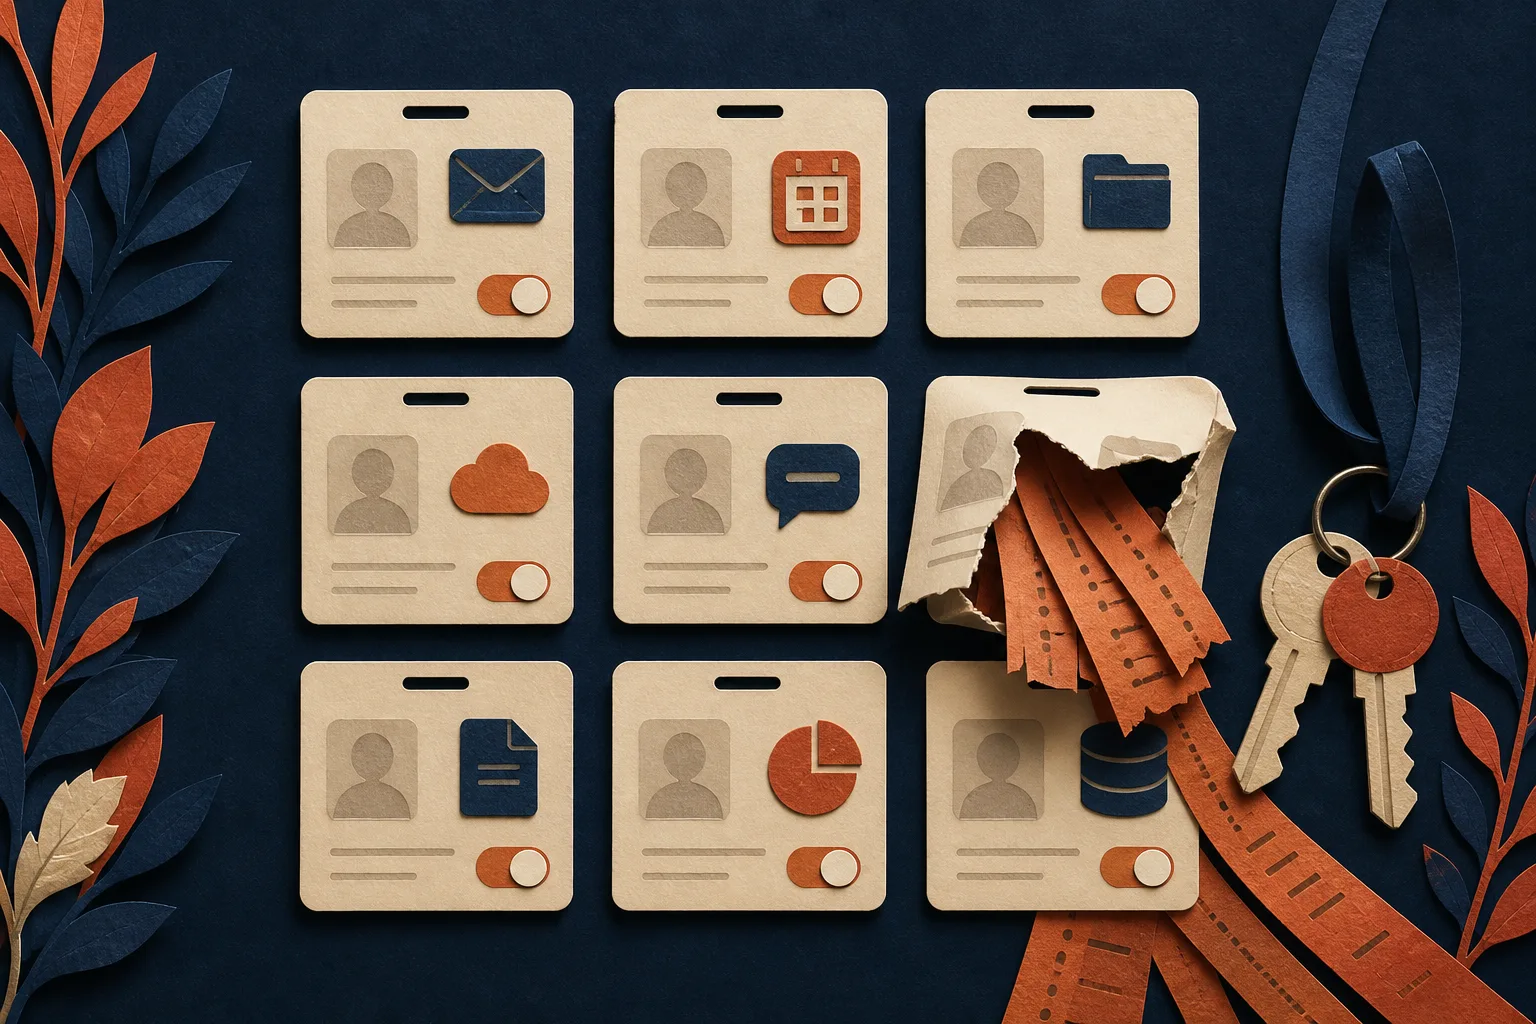
Le scénario le plus courant : quelqu’un connecte l’agent à une app “pour voir”. Puis une deuxième. Puis une troisième. Résultat : ton agent always-on devient une clé passe-partout.
2) Side effects : il “agit” au lieu de préparer
Un agent qui envoie, supprime, modifie, publie… sans garde-fou humain : c’est le plus court chemin vers l’incident (et la perte de confiance interne).
3) Fuite de données : sortie modèle, connecteurs, ou logs
Tu peux perdre des données de trois façons :
- Dans les réponses (copier-coller involontaire d’infos sensibles).
- Via un connecteur (exfiltration vers un outil tiers mal cadré).
- Via des logs trop bavards (rétention longue, contenu sensible stocké “pour debug”).
4) Approval fatigue : trop de validations = on clique sans lire
Si tu mets une approbation sur tout, tu crées une usine à clic. Donc une fausse sécurité. À l’inverse, autonomie totale = roulette russe. La bonne approche : des gates par niveau de risque.
5) Pas d’audit : impossible de reconstruire “qui a fait quoi”
Le jour où ça dérape, tu dois pouvoir prouver :
- Quel prompt ou instruction a lancé l’action.
- Quel outil a été appelé.
- Quelles règles étaient actives (allow/deny/approval).
- Qui a approuvé (ou pas) et quand.
- Quel résultat a été produit.
Si tu n’as pas ça, tu vas gérer l’incident au feeling. Et tu vas perdre du temps, de l’argent, et potentiellement te mettre en risque juridique.
La méthode dirigeant : 9 règles pour des agents IA entreprise “always-on” maîtrisés
Règle 1 : tu délègues une responsabilité, pas une to-do list
Un agent always-on doit avoir une mission claire, avec un livrable.
Mauvais : “fais-moi de la veille et des rapports et réponds aux emails”.
Bon : “chaque lundi 8h, produire une synthèse veille concurrentielle sur 5 concurrents, format 1 page, sources citées, et 3 impacts business possibles”.
Pourquoi : plus c’est flou, plus l’agent improvise. Et plus il improvise, plus il prend des initiatives dangereuses.
Règle 2 : classe toutes les actions en 4 niveaux (Lire / Préparer / Écrire / Exécuter)
C’est ton modèle de gouvernance agents IA le plus rentable, parce qu’il est compréhensible par tout le monde.
- Lire : consulter des sources, ouvrir des fichiers.
- Préparer : analyser, résumer, proposer un brouillon.
- Écrire : créer/modifier des contenus dans un outil (doc, CRM, ticketing).
- Exécuter : envoyer, publier, supprimer, lancer un workflow, déclencher un paiement, changer des droits.
Par défaut : l’agent fait Lire + Préparer. Le reste est sous contrôle.
Règle 3 : tu interdis les actions irréversibles, point
Interdiction par défaut (sauf projet très cadré, très mature) :
- Suppression de fichiers, d’emails, de fiches CRM.
- Publication (site, LinkedIn, ads, fiche Google).
- Changement de mots de passe.
- Modification des droits et partages.
- Virements, remboursements, opérations bancaires.
Ton objectif : éviter le “ça semblait logique” qui finit en catastrophe.
Règle 4 : identité dédiée obligatoire (compte de service), jamais ton compte perso
Un agent always-on doit utiliser une identité de service :
- Compte “agent” séparé, MFA, pas de délégation admin.
- Accès limités à un périmètre (dossier, base, workspace) dédié.
- Pas d’accès aux emails du dirigeant. Jamais.
Ça limite le blast radius. Et ça rend l’audit possible (on voit que c’est l’agent, pas “quelqu’un”).
Règle 5 : un “sandbox” d’abord, la prod ensuite
Tu crées un environnement de test :
- Dossier Drive “VEILLE_TEST”.
- Base Notion “Reporting_TEST”.
- Workspace ou projet séparé si possible.
Objectif : si l’agent se trompe, il casse du faux.
Règle 6 : toutes les actions sensibles passent par un système d’approbation
Tu veux une mécanique type “interruption avant exécution” : l’agent propose, il s’arrête, un humain valide ou rejette, puis il reprend.
Concrètement, tu poses une règle simple :
- Lire + Préparer : automatique.
- Écrire : approbation si ça touche des données métier (CRM, tickets), automatique si c’est dans un bac à sable.
- Exécuter : approbation obligatoire (ou interdit).
Tu évites deux pièges : l’autonomie totale, et l’approval fatigue (valider 50 fois des trucs sans risque).
Règle 7 : logs exploitables ou rien (prompts, tool calls, règles, décisions)
Tu exiges une traçabilité de bout en bout. Le minimum :
- Prompt/instruction à l’origine de l’action.
- App ou outil appelé, avec paramètres (sans stocker les secrets).
- Décision de règles (allow/deny/approval).
- Qui a approuvé, quand.
- Résultat (succès, échec, données écrites).
Et tu cadres la rétention : qui a accès aux logs, combien de temps, et comment tu masques le sensible.
Règle 8 : garde-fous “output” pour éviter la fuite et la connerie
Deux garde-fous simples :
- Redaction : l’agent n’a pas le droit de sortir des identifiants, des données RH, des infos clients nominatives, des numéros, etc. Même si ça “aiderait”.
- Format de sortie imposé : sources citées, niveau de confiance, points à vérifier. Oui, c’est plus long. Mais c’est ce qui évite la note interne fausse qui te fait prendre une mauvaise décision.
Si tu veux cadrer la fiabilité, tu peux t’appuyer sur ce protocole : https://jimmymanin.com/blog/hallucinations-ia-le-protocole-simple-en-5-tests-pour-eviter-lerreur-qui-coute-cher
Règle 9 : plan d’incident prêt avant le “go live”
Un agent always-on, c’est comme un outil financier ou un CRM : tu dois pouvoir le couper.
- Un bouton d’arrêt (désactivation du dot, des connecteurs, ou des permissions).
- Une procédure de rotation des secrets.
- Une procédure de revue des logs sur 24-48h pour comprendre.
- Un responsable nommé (oui, une personne).
Et tu définis une règle claire : “si on observe X (ex : tentative d’accès hors périmètre), on stoppe, on analyse, on corrige, puis on relance”.
Mini-cahier des charges (copie-colle) pour un agent always-on faible risque
Objectif : déployer un agent always-on sur un périmètre qui fait gagner du temps sans exposer de données critiques.
1) Mission
- Responsabilité : Veille concurrentielle hebdo (ou préparation reporting mensuel).
- Livrable : 1 page structurée + liens sources + 3 implications business.
- Cadence : Lundi 8h (veille) ou J-2 avant CODIR (reporting).
2) Périmètre données
- Sources publiques uniquement (sites concurrents, presse, pages pricing).
- Zéro donnée client nominative.
- Zéro RH.
- Zéro finance sensible.
3) Accès (least privilege)
- Lecture web autorisée.
- Accès Drive limité à un dossier “VEILLE” (lecture/écriture).
- Interdit : email, CRM, outils finance, IAM/admin.
4) Modèle d’autonomie
- Lire + Préparer : autonome.
- Écrire : autorisé uniquement dans le dossier dédié.
- Exécuter : interdit (pas d’envoi, pas de publication).
5) Contrôles
- Approbation humaine requise dès qu’une action sort du périmètre.
- Logs complets + rétention définie.
- Revue hebdo 15 minutes des traces (ce qu’il a fait, ce qu’il a tenté de faire).
Checklist déploiement en 2 semaines (périmètre faible risque)
Semaine 1 : cadrage et sécurité (tu poses les rails)
- Jour 1 : choisir 1 mission unique (veille ou reporting). Pas deux.
- Jour 1 : définir le livrable (format, longueur, sources obligatoires, “à vérifier”).
- Jour 2 : définir le périmètre data interdit (clients, RH, finance, juridique).
- Jour 2 : créer le compte de service “agent” + MFA + propriétaire métier.
- Jour 3 : créer le sandbox (dossier, base, workspace dédié) + droits minimaux.
- Jour 3 : connecter uniquement les apps nécessaires. Rien “au cas où”.
- Jour 4 : poser les règles : Lire/Préparer autorisé, Écrire limité, Exécuter interdit.
- Jour 5 : activer journalisation et définir la rétention + accès aux logs.
Semaine 2 : pilote, contrôle, go/no-go
- Jour 6-7 : faire tourner l’agent sur 2 cycles complets (2 veilles, ou 1 reporting test) en sandbox.
- Jour 8 : revue des sorties (qualité) + revue des logs (comportement).
- Jour 9 : ajuster prompts, règles, formats, limites (ex : sources autorisées).
- Jour 10 : définir le protocole d’incident (qui stoppe, comment, où regarder).
- Jour 11-12 : passage en “prod limitée” (même périmètre, même accès, juste livrable officiel).
- Jour 13 : point dirigeant 20 minutes : temps gagné réel ? risques acceptables ?
- Jour 14 : décision go/no-go, puis plan d’extension par paliers (un accès à la fois).
Quels cas d’usage tu dois déléguer en premier (et lesquels tu refuses)
Bon départ (faible risque, ROI temps rapide)
- Veille concurrentielle (sources publiques, livrable interne).
- Préparation de reporting (à partir de données déjà validées, dans un dossier dédié).
- Préparation de réunions : ordre du jour, synthèse d’infos, questions à poser.
- Contrôle de cohérence : détecter les trous dans un dossier, demander des pièces manquantes (sans contacter le client).
Interdit au début (et souvent interdit tout court)
- Email sortant autonome (surtout aux clients).
- CRM en écriture sans workflow brouillon + validation.
- Finance (paiements, remboursements, relances automatiques).
- Admin IT (droits, IAM, mots de passe, gestion d’accès).
Si tu veux cadrer plus largement tes agents, tu as déjà une base solide ici : https://jimmymanin.com/blog/agents-ia-en-entreprise-checklist-securite-en-12-points-anti-fuite-avant-deploiement
Le test dirigeant : “Est-ce que je peux défendre ce design devant mon assureur et mon DPO ?”
Avant d’étendre un agent always-on, pose-toi ces 6 questions :
- Si l’agent fait n’importe quoi, c’est quoi le pire scénario ? (argent, données, réputation)
- Quel est le blast radius avec ses accès actuels ?
- Qu’est-ce qui est irréversible ? Est-ce interdit ?
- Où sont les logs et qui peut les lire ?
- Qui approuve quoi et à quel moment ?
- Comment je coupe en moins de 5 minutes ?
Si tu n’as pas des réponses nettes, tu n’as pas un système. Tu as un risque.
Ce que tu fais maintenant (30 minutes, pas plus)
- Choisis un cas faible risque (veille ou reporting).
- Écris les 4 niveaux Lire / Préparer / Écrire / Exécuter et coche ce qui est autorisé.
- Liste les accès nécessaires. Puis supprime la moitié. Il doit rester le strict minimum.
- Décide : qui approuve les actions sensibles.
- Décide : où sont les logs et combien de temps tu les gardes.
Après ça, tu peux tester OpenAI Dots ou n’importe quel autre système d’agents IA entreprise sans partir en roue libre. Tu n’achètes pas “de l’IA”. Tu mets en place une délégation contrôlée.
Si tu veux aller plus loin sur la logique d’autonomie contrôlée, ce cadre complète bien ce protocole : https://jimmymanin.com/blog/agents-ia-le-modele-3-niveaux-dautonomie-pour-automatiser-sans-provoquer-lincident