Le cas concret (et très fréquent)
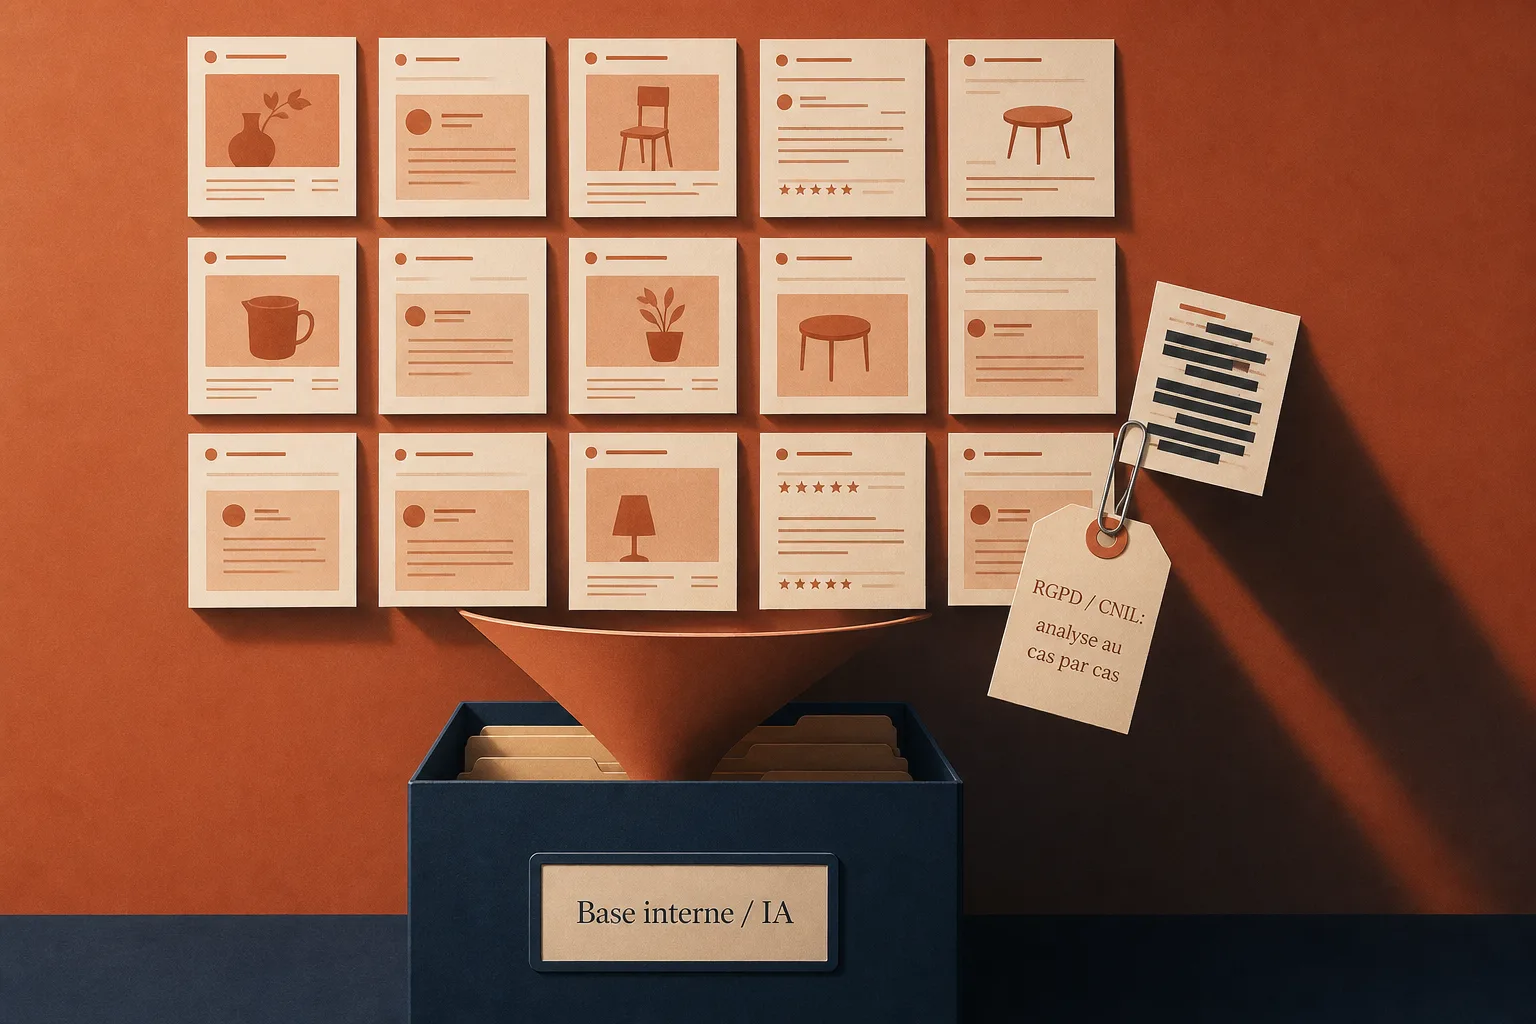
Tu veux scraper des sites pour créer une base de connaissance interne, ou pour entraîner un modèle. Exemple classique : tu prends des pages publiques (articles, fiches produits, annuaires, forums, avis), tu les “aspire”, tu les mets dans une base, puis tu branches une IA dessus (RAG, chatbot, moteur de recherche sémantique) ou tu t’en sers comme dataset d’entraînement.
Sur le papier, ça ressemble à : “c’est public, donc c’est bon”. En vrai, c’est là que tu te mets dans le mur.
La CNIL le dit sans détour : le web scraping n’est pas interdit en soi, mais ça demande une analyse au cas par cas, des garde-fous, et ça sort vite des attentes raisonnables si tu forces la collecte (robots.txt, CAPTCHA, restrictions techniques, conditions d’utilisation, etc.). Et côté Europe, le sujet n’est plus “gris” : l’EDPB travaille sur des lignes directrices dédiées au web scraping dans le contexte de l’IA générative (consultation ouverte du 8 juillet au 30 octobre 2026). Traduction dirigeant : tu dois te comporter comme si tu allais devoir justifier ton dispositif, noir sur blanc.
Le point de départ : “public” ne veut pas dire “libre”
Trois réalités que beaucoup découvrent trop tard :
- Public ≠ réutilisable. Une page accessible sans login peut contenir des données personnelles, donc RGPD.
- Scraper “un peu” ≠ scraper “massivement”. Le volume change tout : risque, attentes raisonnables, effort d’information, difficulté d’effacement.
- Ton risque ne s’arrête pas au dataset. Un modèle entraîné sur des données personnelles peut rester dans le périmètre RGPD (risque de mémorisation, extraction, fuites via les sorties). Donc il faut cadrer dataset, modèle et usage.
Objectif de cet article : te donner une méthode simple, actionnable, pour décider ce que tu peux faire, ce que tu dois cadrer, et comment passer d’un bricolage à un dispositif défendable.
Méthode : 7 questions pour décider si ton scraping IA est “conforme” ou “suicidaire”
Tu peux traiter ça comme une checklist de validation avant de lancer le moindre crawler. Si tu bloques sur une question, tu n’as pas “un détail à régler”, tu as un risque structurel.
1) Finalité : tu fais ça pour quoi, exactement ?
Écris la finalité en une phrase, sans jargon. Exemples :
- “Créer une base de connaissance interne pour aider le support à répondre plus vite.”
- “Indexer des pages publiques de concurrents pour surveiller les prix.”
- “Constituer un dataset pour entraîner un modèle de génération de texte.”
Ensuite, pose la question qui tue : est-ce que j’ai vraiment besoin de données personnelles pour cette finalité ?
- Pour une base de connaissance “produits / réglementation / procédures”, la réponse est souvent non. Dans ce cas, tu dois organiser ton scraping pour éviter les données perso.
- Pour un entraînement générique “de texte du web”, tu vas en collecter, même “sans le vouloir”. Et là, ton niveau d’exigence monte d’un cran.
Décision dirigeant : si ta finalité est floue (“améliorer l’IA”), tu n’arriveras pas à défendre minimisation, conservation, information. Donc tu n’es pas prêt.
2) Base légale : sur quoi tu t’appuies ?
Pour du scraping IA, l’option la plus invoquée est l’intérêt légitime. La CNIL indique que la constitution d’une base d’apprentissage à partir de données accessibles en ligne peut, dans certains cas, reposer dessus, mais avec une analyse au cas par cas et des mesures.
Concrètement, “intérêt légitime” = tu dois faire un test en 3 étapes, documenté :
- Objectif légitime : ex. améliorer ton support, réduire les délais, augmenter la qualité de service.
- Nécessité : prouver que tu ne peux pas atteindre le même résultat avec moins intrusif (API officielle, sources internes, partenariats, données agrégées).
- Mise en balance : évaluer l’impact sur les personnes, leurs attentes raisonnables, et les garanties que tu mets.
Signal d’alerte immédiat : si le site cible montre une opposition explicite (robots.txt, CAPTCHA, restrictions techniques, clauses anti-scraping), tu sors vite des attentes raisonnables. Et ton “intérêt légitime” devient beaucoup plus difficile à défendre.
3) Données sensibles : tu vas en aspirer, même “par accident” ?
Les données sensibles (santé, opinions, religion, orientation, etc.) et les données de mineurs, c’est le champ de mines.
La CNIL insiste sur un point clé : la collecte incidente est un risque prévisible, pas un accident excusable. Donc “on collecte tout puis on triera” est une mauvaise idée. Le RGPD attend l’inverse : minimisation dès la conception.
Mesures concrètes à décider avant le scraping :
- Liste d’exclusion : types de sites à bannir (forums santé, groupes, pages perso, commentaires non modérés, etc.).
- Règles de filtrage : champs interdits (emails, numéros, adresses), patterns à supprimer, suppression immédiate des données non pertinentes.
- Échantillonnage : tester sur un petit volume pour voir ce que tu collectes réellement.
Décision dirigeant : si tu ne peux pas expliquer comment tu évites et supprimes les sensibles, tu n’es pas en contrôle.
4) Information des personnes : comment tu gères l’article 14 ?
Scraping = collecte indirecte. Donc l’article 14 RGPD s’applique : tu dois informer les personnes “dès que possible” et au plus tard dans le mois après récupération des données (cadre rappelé par la CNIL dans le contexte IA).
Dans la vraie vie, c’est là que les entreprises bricolent. “Efforts disproportionnés” est souvent brandi comme excuse. Mauvais réflexe : la CNIL attend une analyse documentée au cas par cas (nombre de personnes, ancienneté des données, moyens de contact, coûts, garanties, etc.).
Bonnes pratiques opérationnelles (CNIL) :
- Si tu scrape peu de sites : informe précisément sur les sources.
- Si tu scrape beaucoup de sites : au minimum, catégories de sources, et priorité aux sources les plus risquées.
- Si les données sont sensibles : laisse un délai raisonnable entre l’information et l’entraînement pour permettre l’exercice des droits avant entraînement.
Décision dirigeant : tu choisis entre deux voies. Soit tu construis un dispositif d’information et de gestion des droits. Soit tu changes le design pour éviter les données personnelles et sortir du sujet.
5) Minimisation : tu collectes quoi, au strict nécessaire ?
Minimisation = tu définis à l’avance ce que tu veux extraire, et tu prouves que tu ne prends pas “tout”.
Exemples de règles de minimisation pour une base de connaissance IA RGPD-friendly :
- Tu ne scrapes que des pages “documentation”, pas les commentaires, pas les profils auteurs, pas les pages “équipe”.
- Tu stockes le contenu utile, pas les identifiants, pas les paramètres d’URL, pas les trackers.
- Tu tronques ou supprimes les infos perso (emails, numéros) à l’ingestion.
- Tu conserves un lien vers la source plutôt que recopier des blocs entiers quand ce n’est pas nécessaire.
Minimisation technique : mets des garde-fous au niveau crawler (URL allowlist), parser (champs autorisés), pipeline (détection et suppression), et stockage (schéma limité).
6) Durée de conservation : tu gardes combien de temps, et pourquoi ?
“On garde tout, ça peut servir” est exactement ce qu’il ne faut pas faire.
Décide :
- Durée de conservation du dataset brut (souvent courte, ex. 30 à 90 jours) pour pouvoir rejouer, auditer, corriger.
- Durée de conservation de l’index (base de connaissance) avec une logique de rafraîchissement.
- Politique de purge : suppression programmée, traçable, avec logs.
Si tu entraînes un modèle, pose la question explicitement : que se passe-t-il si quelqu’un exerce un droit à l’effacement après entraînement ? Si tu n’as pas de réponse opérationnelle, tu as un risque. Même si c’est “dur techniquement”, tu dois au minimum avoir un process (restriction d’usage, retrain, blacklist, contrôle des sorties).
7) Sous-traitants et transferts : où vont tes données, et qui y touche ?
Ton scraping IA va souvent passer par :
- un prestataire (dev, intégrateur),
- un cloud (stockage, compute),
- un outil IA (LLM, embeddings, moteur RAG),
- un outil d’observabilité (logs, monitoring).
Décisions à trancher :
- Qui est responsable de traitement ? Souvent toi.
- Qui est sous-traitant ? Prestataires et fournisseurs, avec clauses et instructions.
- Transferts hors UE ? Si oui, tu dois le savoir et l’assumer contractuellement et techniquement.
- Accès internes : qui peut voir le dataset brut ? Qui peut relancer un crawl ? Qui peut exporter ?
Point dirigeant : le risque le plus fréquent n’est pas “le RGPD en théorie”. C’est la fuite via un outil IA mal cadré, un bucket mal configuré, ou un accès trop large. Si tu déploies des agents ou des automatisations, recoupe avec ta checklist sécurité interne. Tu peux t’appuyer sur cet article : Agents IA en entreprise : checklist sécurité en 12 points anti-fuite (avant déploiement).
Ce que tu peux vraiment faire (sans te raconter d’histoires)
Trois scénarios “réalistes” côté entreprise, du plus safe au plus risqué :
Scénario A (le plus propre) : base de connaissance sans données personnelles
Tu fais du scraping avec allowlist stricte, tu exclus tout ce qui ressemble à des données perso, tu indexes uniquement de la doc, des pages institutionnelles, des contenus B2B non centrés sur des individus. Tu alimentes un RAG interne. Tu réduis fortement le sujet “données personnelles IA entreprise”.
Scénario B (gérable mais exigeant) : base de connaissance avec données perso “incidentes”
Tu acceptes qu’il y en aura, mais tu mets des filtres et une purge immédiate, tu documentes intérêt légitime, tu gères l’information article 14, tu mets un process de droits (accès, suppression), et tu limites les accès internes. Ça se fait, mais c’est un vrai dispositif, pas un script lancé le vendredi soir.
Scénario C (le plus risqué) : entraînement d’un modèle sur scraping web large
Là, tu joues dans la cour des exigences lourdes : risques de mémorisation, difficulté d’effacement, volume massif, attentes raisonnables, information des personnes à grande échelle. Possible dans certains cas, mais tu dois accepter le coût conformité et le coût technique. Sinon, change de stratégie (sources sous licence, données internes, partenariats, données synthétiques, etc.).
Plan d’action 30 jours : passer d’un bricolage à un dispositif documenté
Objectif : en 30 jours, tu passes de “on scrape” à “on sait ce qu’on fait, on peut le prouver, et on réduit le risque”.
Semaine 1 : cadrage et stop aux conneries
- Décide la finalité (1 phrase) et le périmètre (quels sites, quelles pages, quel usage IA).
- Choisis le scénario (A, B ou C). Si tu vises A, écris noir sur blanc “zéro données perso visées”.
- Inventorie les sources : liste des sites, signaux d’opposition (robots.txt, CAPTCHA, conditions), niveau de risque.
- Fige une règle : pas de contournement technique (CAPTCHA, restrictions). Si tu dois contourner, c’est déjà un signal que tu t’éloignes des attentes raisonnables.
Semaine 2 : base légale, registre, et test intérêt légitime
- Rédige ton test d’intérêt légitime (objectif, nécessité, balance, garanties).
- Crée l’entrée de registre (traitement “web scraping IA”, finalité, catégories de données, destinataires, durées, mesures).
- Décide si une DPIA est nécessaire : volume élevé, données sensibles possibles, profilage, impact fort, difficulté d’exercice des droits. Si oui, tu la lances. Si tu ne sais pas, considère que c’est un signal de DPIA à évaluer sérieusement.
Semaine 3 : règles d’extraction, minimisation, et preuves
- Écris des règles d’extraction : allowlist d’URL, champs autorisés, types de pages interdites.
- Mets des filtres : suppression d’emails/tél, exclusion de patterns, blacklist de domaines risqués.
- Ajoute des logs : quand tu scrapes, quoi, combien, source, version des règles, taux de suppression.
- Organise le stockage : dataset brut séparé, accès restreint, chiffrement si possible, expiration automatique.
Semaine 4 : information, droits, purge, et contractualisation
- Écris la notice d’information (article 14) et décide du canal (page dédiée, contact, modalités).
- Crée un process “droits RGPD” : comment une personne demande, comment tu retrouves ses données (indexation par source, identifiants), comment tu effaces, sous quel délai, qui exécute, quelles preuves tu gardes.
- Automatise la purge : jobs de suppression, logs de purge, contrôle.
- Cadre les sous-traitants : qui fait quoi, où sont les données, clauses, transferts hors UE si applicable, limitation d’accès.
Checklist express : si tu dois décider aujourd’hui
- Si tu ne peux pas expliquer ta finalité en 10 secondes : stop, recadre.
- Si tu dois contourner robots.txt / CAPTCHA : stop, change de source ou de méthode.
- Si tu collectes “tout puis tri” : stop, redesign minimisation.
- Si tu n’as pas de plan d’information (article 14) et de gestion des droits : soit tu changes pour éviter la donnée perso, soit tu construis le dispositif.
- Si tu entraînes un modèle : traite le modèle comme une partie du risque, pas juste le dataset.
Le move le plus rentable : réduire le périmètre plutôt que “gérer le chaos”
Le réflexe “dirigeant” à adopter : avant d’investir dans des process RGPD lourds, demande-toi si tu peux atteindre 80% du gain avec 20% du risque.
Souvent, la bonne stratégie pour une PME, ce n’est pas “scraper tout le web”. C’est :
- prioriser des sources maîtrisées (tes docs internes, ton site, tes contrats, tes procédures, tes tickets support),
- ajouter quelques sources externes propres (docs officielles, pages institutionnelles),
- et construire une base de connaissance IA RGPD qui te fait gagner du temps sans aspirer la vie privée des gens.
Si tu veux une méthode de cadrage plus large (RGPD + AI Act) avant de lancer un cas d’usage IA, tu peux recouper avec : AI Act + RGPD : la méthode en 10 questions pour valider un cas d’usage IA avant de lancer.
Prochaine action (simple, mais qui change tout)
Prends ton cas “scraping IA conformité” et réponds aux 7 questions dans un document d’une page. Pas un roman. Une page.
- Si tu n’arrives pas à répondre à une question : tu viens d’identifier ton vrai risque.
- Si tu réponds à tout : tu as une base défendable, et tu peux industrialiser avec le plan 30 jours.
Le scraping n’est pas “interdit”. Mais en 2025-2026, il est en train de devenir un sujet explicitement encadré pour l’IA générative. Donc soit tu fais propre et documenté, soit tu t’exposes pour un gain qui, souvent, peut être obtenu autrement.