Vous demandez deux fois la même chose à ChatGPT. Vous obtenez deux réponses différentes. Frustrant quand vous cherchez un chiffre ou une clause de contrat. Normal, en fait. Il existe un réglage qui gouverne ce comportement. Il s'appelle la température. La plupart des dirigeants ne savent même pas qu'il existe. C'est dommage, parce que ce curseur décide si votre IA est un comptable fiable ou un publicitaire qui part en roue libre.
On va poser les choses simplement. Ce que c'est. Quand la baisser. Quand la monter. Où la trouver. Et une règle que vous pourrez appliquer dès aujourd'hui.
La température, c'est quoi concrètement
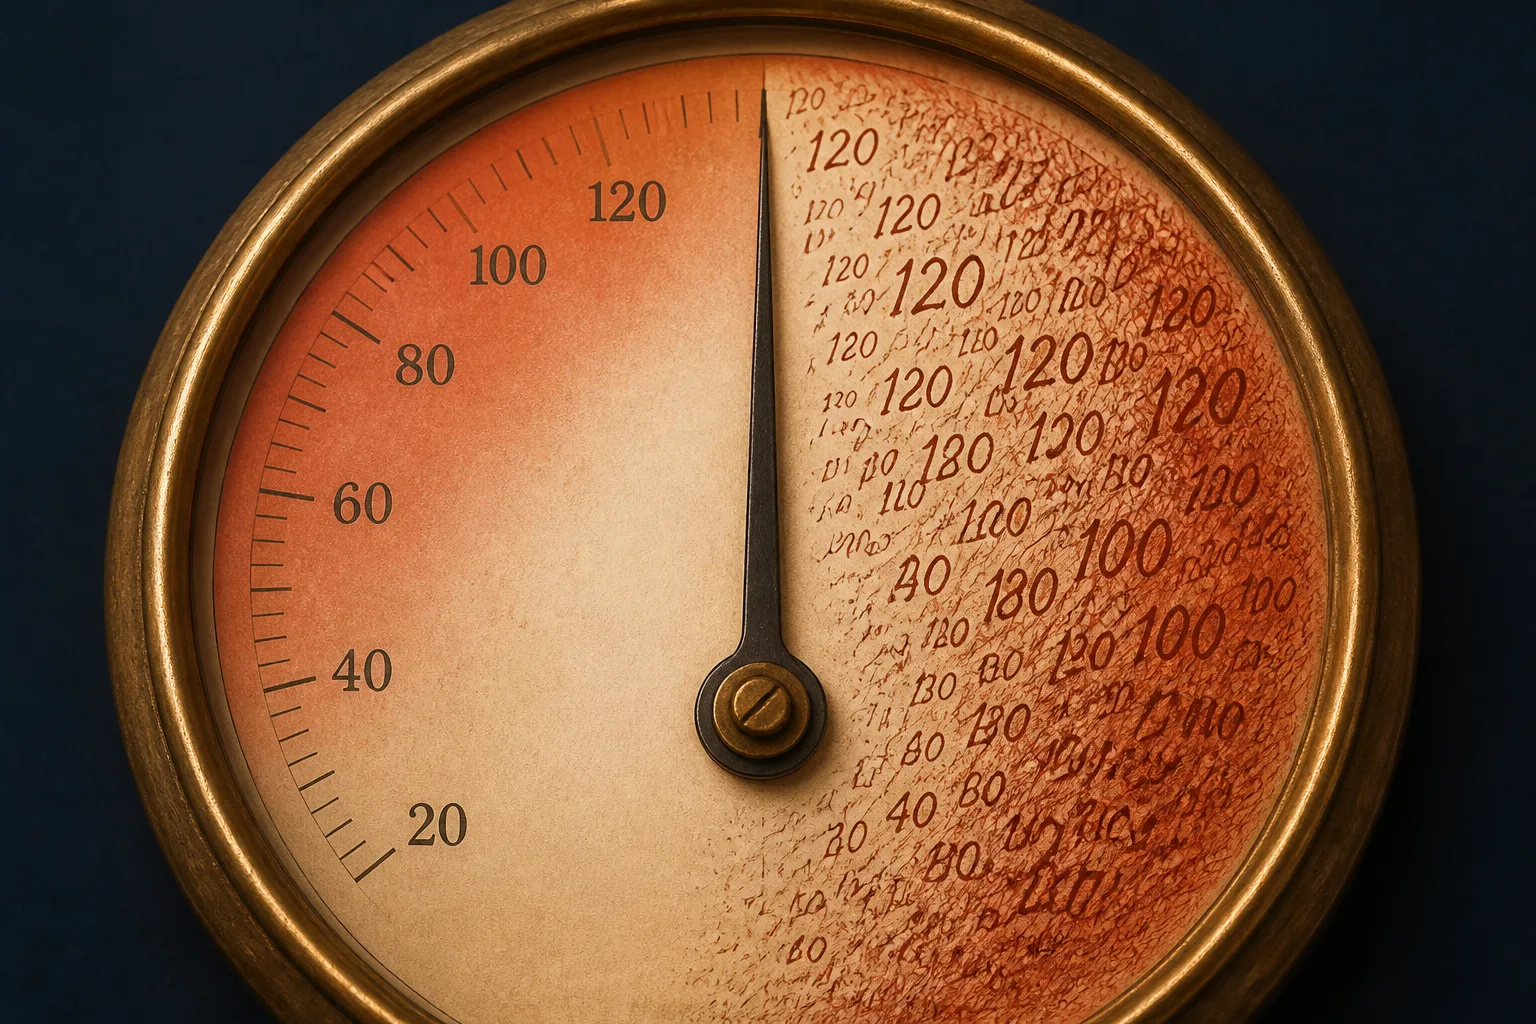
Un modèle d'IA ne connaît pas la réponse. Il prédit le mot suivant, un par un. À chaque étape, il a une liste de mots candidats, chacun avec une probabilité. La température règle une seule chose : à quel point le modèle ose choisir un mot moins probable.
Température basse : le modèle joue la sécurité. Il prend presque toujours le mot le plus probable. Résultat prévisible, factuel, répétable.
Température haute : le modèle prend des risques. Il pioche des mots moins évidents. Résultat plus varié, plus créatif, parfois surprenant, parfois n'importe quoi.
Techniquement, ce réglage modifie les probabilités via une fonction mathématique (la softmax, si vous voulez le mot exact). Mais vous n'avez pas besoin de la formule. Retenez l'image : la température, c'est le taux d'audace du modèle.
Un point d'honnêteté important. Une température à 0 rend le modèle "greedy" : il choisit toujours le mot le plus probable. Ça le rapproche du déterminisme, donc de la même réponse à chaque fois. Mais ça ne le garantit pas à 100 %. Des micro-variations au niveau du matériel qui fait tourner le modèle peuvent introduire de légères différences. Ne promettez donc jamais à personne que votre IA donnera un résultat identique au caractère près. Elle sera très stable. Pas gravée dans le marbre.
Quand baisser la température
Dès que la précision compte plus que le style, vous descendez. Zone 0 à 0,3. C'est la zone des faits, des chiffres, du droit et du code.
- Extraction d'un contrat. Vous voulez la date, le montant, la clause de résiliation. Pas une interprétation créative.
- Calculs et analyse de chiffres. Une IA qui "ose" sur vos marges, c'est une IA qui vous ment avec assurance.
- Réponses au service client. Vous voulez que la même question donne toujours la même réponse fiable. Pas trois versions selon l'humeur du modèle.
- Reformulation de documents officiels. Conditions générales, mentions légales, procédures internes. Zéro fantaisie.
La logique de dirigeant est simple. Sur ces tâches, une erreur coûte du temps, de la crédibilité ou de l'argent. Une réponse ennuyeuse mais juste vaut mille fois mieux qu'une réponse brillante mais fausse. Vous baissez le curseur pour réduire le risque.
Quand monter la température
Quand vous cherchez des idées, de la variété, un angle inattendu. Zone 0,7 à 1. C'est la zone de la créativité.
- Brainstorming. Trente noms de produit, dix angles de campagne, cinq façons de présenter une offre. Vous voulez de la diversité, pas la réponse la plus prévisible.
- Rédaction marketing. Un post LinkedIn, une accroche, une newsletter. Un peu d'audace donne du relief.
- Exploration. "Donne-moi des usages auxquels je n'ai pas pensé." Là, l'audace du modèle est un atout.
Attention au plafond. Certaines API montent jusqu'à 2. Mais au-delà de 1,2 ou 1,3, le modèle commence souvent à produire des phrases incohérentes ou carrément absurdes. Monter le curseur n'a pas d'intérêt linéaire. Passé un certain point, vous ne gagnez pas en créativité, vous gagnez du bruit. Restez sous 1,2 dans quasiment tous les cas.
Où trouver ce réglage (mauvaise nouvelle pour ChatGPT)
Voilà le point que peu de gens comprennent. Dans l'interface ChatGPT que vous utilisez tous les jours, ce curseur n'existe pas. Vous ne pouvez pas régler la température. OpenAI la gère en interne et peut la faire varier selon le modèle. Même chose sur Claude.ai. Pas de curseur visible.
Donc dans un usage "chat" classique, vous ne touchez pas ce paramètre. Vous pouvez seulement influencer le style par votre prompt. Dire "réponds de façon factuelle, sans reformuler, uniquement les données du document" pousse indirectement vers un comportement plus stable. Ça ne remplace pas un vrai réglage, mais c'est votre seul levier dans le chat.
Pour contrôler réellement la température, il faut passer par un des canaux techniques suivants :
- Le Playground d'OpenAI. Une interface web avec un curseur dédié. Idéale pour tester avant de figer un réglage.
- Les API (OpenAI, Claude, Gemini). Là vous passez le paramètre directement dans la requête. À noter : OpenAI et Gemini vont de 0 à 2, valeur par défaut souvent à 1. Claude est plus restreint, de 0 à 1.
- Les outils no-code comme n8n. Certains nœuds IA exposent la température directement dans un champ à remplir. Pratique si vous montez une automatisation sans coder.
- Les Custom GPT. Exception utile : quand vous créez un GPT sur mesure via le GPT Builder d'OpenAI, vous pouvez fixer la température à la configuration. Vous cadrez ainsi le ton d'un assistant interne une fois pour toutes.
Concrètement, dans une requête API, ça ressemble à ça : un appel qui envoie votre modèle, votre demande, et un champ "temperature" réglé à 0.3 par exemple. Si vous faites développer un outil interne, c'est exactement le genre de détail à cadrer avec la personne qui le construit. Demandez-lui quelle température elle a mise sur quelle tâche. Si elle ne sait pas répondre, c'est un signal.
Le changement récent que vous devez connaître
Un mouvement de fond mérite votre attention. Sur les modèles de raisonnement récents (o1, o3, la série GPT-5), OpenAI a tout simplement supprimé la possibilité de régler la température via l'API. Un développeur qui tente d'envoyer ce paramètre reçoit une erreur. Le modèle refuse.
Pourquoi ? Ces modèles gèrent leur propre processus de raisonnement en interne. Le fournisseur a décidé que laisser l'utilisateur bidouiller la température n'avait plus de sens sur ce type d'architecture. Retenez la conséquence pratique : selon le modèle que vous choisissez, ce levier peut exister ou avoir disparu. Ne construisez pas un process qui repose sur un réglage de température si vous prévoyez de basculer vers un modèle de raisonnement.
La règle simple à appliquer
Vous n'avez pas besoin de tester dix valeurs. Trois paliers suffisent.
- 0 à 0,3 : tout ce qui doit être juste et stable. Chiffres, contrats, extraction de données, réponses client standardisées, code. Vous voulez de la fiabilité, vous descendez.
- 0,7 à 1 : conversation générale et contenu. Un assistant qui doit rester fiable mais un peu vivant, de la rédaction, du dialogue. C'est la zone d'équilibre.
- 1 à 1,2 : pure créativité. Brainstorming, idées marketing, exploration. Vous acceptez le grain de folie. Vous ne montez pas plus haut.
Question à vous poser avant chaque usage : est-ce que je veux la bonne réponse, ou plusieurs réponses possibles ? Si vous voulez la bonne réponse, vous baissez. Si vous voulez du choix, vous montez. C'est aussi binaire que ça au départ, et ça suffit dans 90 % des cas.
Deux réflexes à garder. Premier : dans le chat classique de ChatGPT ou Claude, vous n'avez pas ce curseur, donc jouez sur le prompt et acceptez une part de variabilité. Deuxième : dès que vous faites monter en puissance un usage sérieux (support client, traitement de documents, analyse de chiffres), passez par un outil qui vous donne le contrôle, et calez une température basse. La fiabilité de vos réponses, sur ces sujets, vaut bien deux minutes de réglage.
Testez sur une vraie tâche cette semaine. Prenez une extraction de données que vous faites régulièrement. Faites-la une fois dans le chat, une fois dans le Playground avec température à 0,2. Comparez la stabilité. Vous verrez tout de suite pourquoi ce réglage caché mérite votre attention.