Tu as déjà ChatGPT. Ce qui manquait, c’était la data vivante
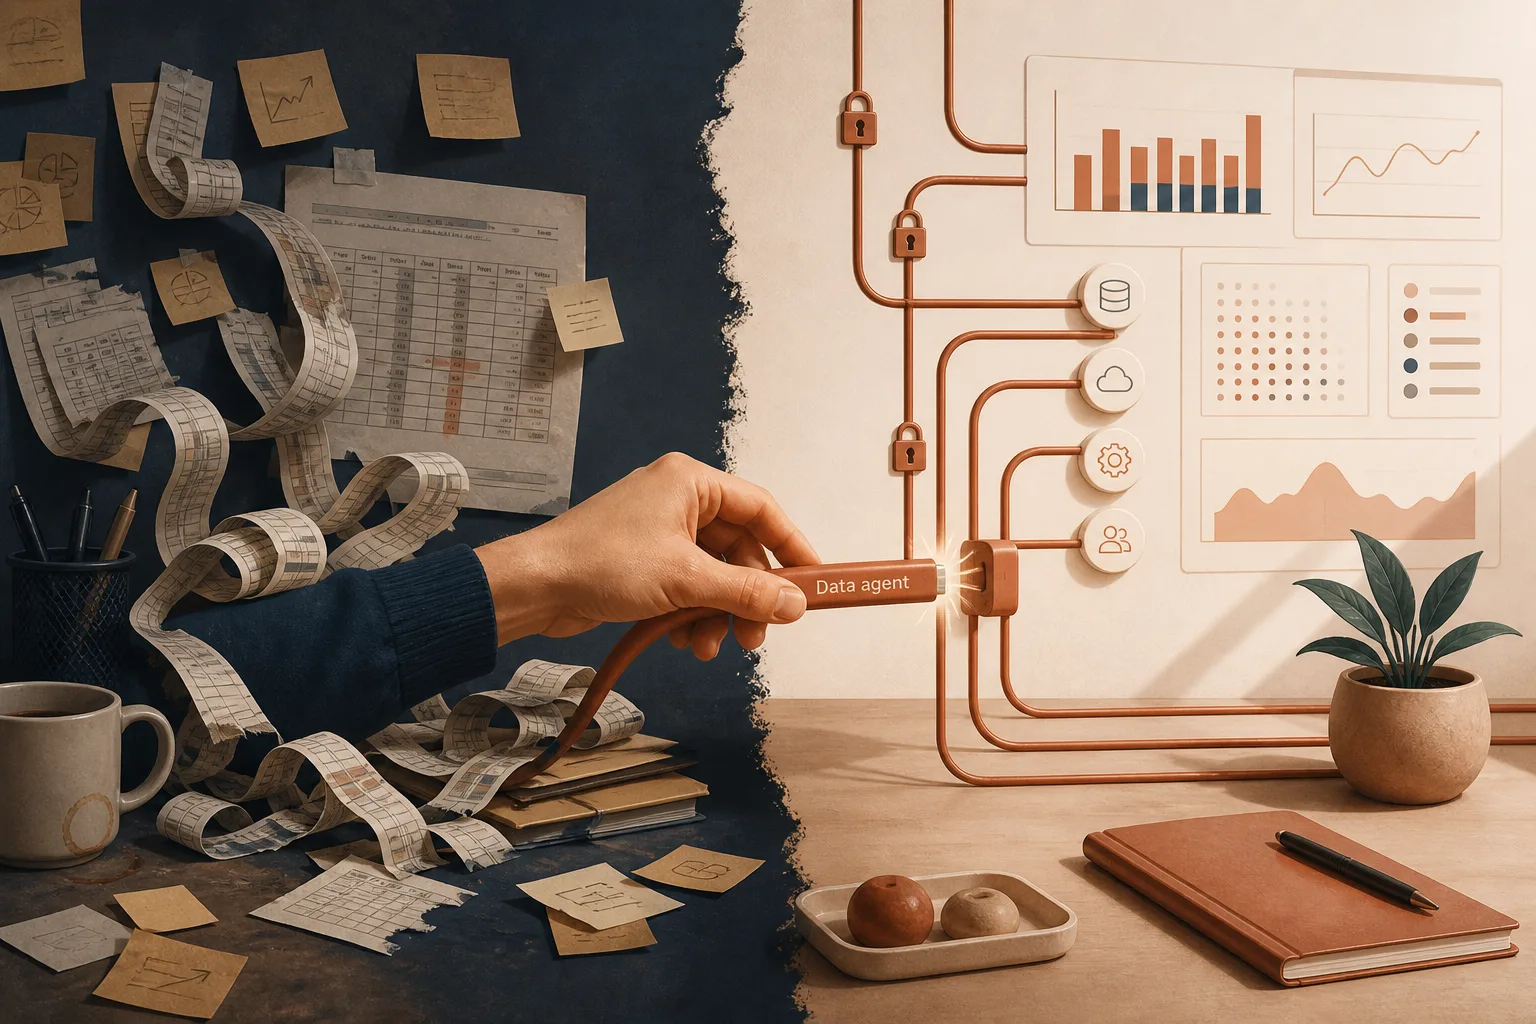
Dans beaucoup de PME, le “reporting” ressemble à ça : export Excel, copier-coller, tableau bricolé, chiffres pas à jour, et une réunion où tout le monde débat… de la fiabilité des données plutôt que des décisions.
Un ChatGPT classique sait analyser un fichier que tu lui donnes. Mais il reste “hors sol” : il ne sait pas se brancher proprement sur tes sources, il ne sait pas gérer les droits, et tu retombes vite dans le copier-coller manuel.
Le changement avec un ChatGPT Data agent (dans une approche type ChatGPT Work) est simple : tu passes du tableau statique au questionnement sur des données connectées, avec des connexions approuvées, un périmètre contrôlé, et des réponses qui se basent sur des chiffres à jour (via connecteurs et sync selon les sources).
Ce n’est pas de la BI magique. C’est un accélérateur de pilotage. À une condition : tu cadres le jeu de données, les requêtes, et les garde-fous. Sinon tu crées un “reporting fantôme” qui produit des décisions sur des chiffres faux.
Ce que “ChatGPT Data agent” change concrètement (vs ChatGPT “classique”)
1) Moins de copier-coller, plus de connexions gouvernées
Le Data agent peut se connecter à des sources approuvées par l’admin (exemples souvent cités : entrepôts et bases type Snowflake, BigQuery, Redshift, MongoDB, Databricks, ClickHouse… et aussi des fichiers dans Google Drive ou SharePoint).
Résultat : les équipes posent des questions sur des données “vivantes”, au lieu de travailler sur des exports déjà obsolètes.
2) Tu gagnes du temps sur la partie la plus chère : formuler, itérer, expliquer
Dans un projet BI, une grosse part du coût n’est pas le calcul du KPI. C’est :
- traduire la question métier en métriques, dimensions, règles, exclusions,
- écrire et corriger des requêtes,
- documenter, rendre lisible, expliquer aux opérationnels.
Le Data agent accélère ces boucles. Il propose des requêtes “read-only”, il teste des angles, il génère des vues de contrôle, il reformule en langage dirigeant.
3) La gouvernance devient un sujet “outillé”, pas juste un PowerPoint
En entreprise, ce qui bloque, ce n’est pas “l’IA”. C’est : droits d’accès, traçabilité, confidentialité, conformité.
La tendance 2025-2026 est claire : connecteurs + contrôle admin + rôles (RBAC) + logs. Tu peux limiter qui voit quoi, et tu peux auditer. Et sur les offres workspace business, il y a généralement une promesse “pas d’entraînement sur vos données business” par défaut via connecteurs (à valider dans ton contrat et tes réglages).
La méthode en 4 étapes : de ta question de dirigeant à un mini-dashboard exploitable
Tu veux déployer vite sans projet data à 6 chiffres ? Arrête de viser “le datawarehouse parfait”. Vise un pilotage minimum viable sur 1 sujet, en 2 semaines, avec un périmètre propre.
Étape 1 : Cadrer la question en “métrique + décision + fréquence”
Tu pars toujours d’une décision. Pas d’un KPI.
- Métrique : qu’est-ce qu’on mesure exactement ?
- Décision : qu’est-ce que tu vas faire si le chiffre monte ou baisse ?
- Fréquence : quotidien, hebdo, mensuel ?
- Seuils : à partir de quand tu déclenches une action ?
- Niveau de confiance requis : “indicatif” ou “pilotage cash” ?
Exemple marge : “La marge baisse” devient “marge brute par famille produit, par client, par mois; décision = ajuster prix, limiter remises, renégocier achats; fréquence = hebdo + mensuel; seuil = -2 points vs moyenne 3 mois; confiance = élevée”.
Étape 2 : Définir le “jeu de données minimum viable” (MDV)
Règle simple : 1 table de faits + 2 à 5 dimensions max. Si tu pars sur 20 tables, tu repars pour 6 mois.
Exemples de MDV (par sujet) :
- Marge : lignes de vente (date, client, produit, quantité, prix, remise, coût, avoirs si possible).
- Retards (OTD) : commandes/livraisons (date promise, date expédition/livraison, statut, client, site, transporteur).
- Stocks : stock théorique + mouvements (entrées/sorties) + ruptures + délais d’appro.
- Impayés : factures (date émission, échéance, statut paiement, montant, client, relances).
- RH : effectifs, absences, turnover, délai de recrutement (attention données sensibles).
Test “dirigeant” : si tu ne sais pas qui est propriétaire de chaque champ, tu n’automatises rien. Sinon tu vas industrialiser des erreurs.
Étape 3 : Écrire 10 requêtes types (ton standard de pilotage)
Tu ne veux pas “faire de la BI”. Tu veux toujours les mêmes 10 questions, bien posées, avec les mêmes définitions.
Structure tes 10 requêtes en 3 familles :
- Santé globale : KPI, tendance, variance vs N-1 ou vs budget.
- Drivers : top/bottom, Pareto 80/20, segmentation.
- Anomalies : doublons, valeurs aberrantes, trous de données, ruptures de série.
Le Data agent sert ici de copilote SQL : tu lui demandes de générer une requête “read-only”, tu la testes, tu ajustes, tu la figes. Puis tu documentes la définition. Tu transformes un débat en un standard.
Étape 4 : Produire un dashboard exploitable (et gouverné)
Dashboard “dirigeant” = pas plus de 6 à 10 tuiles.
- 3 KPI (niveau actuel)
- 2 tendances (sur 8 à 12 semaines ou 12 mois)
- 2 découpes (ex : client et famille produit)
- 1 liste d’alertes actionnables (top 10 anomalies à traiter)
Et tu ajoutes systématiquement :
- définition du KPI (ce qui est inclus/exclu),
- période et comparaison,
- source et “dernière mise à jour”,
- niveau de qualité (complet/incomplet, champs manquants).
Sans ça, tu as un joli écran. Pas un outil de pilotage.
7 cas d’usage BI et pilotage PME à déployer sans projet data à 6 chiffres
Chaque cas d’usage ci-dessous suit la même logique : un MDV réduit, 10 requêtes types, et un mini-dashboard. Tu peux les lancer un par un. Pas besoin d’un “big bang”.
1) “Marge réelle” : prix, remises, coûts, avoirs
Objectif : repérer où la marge se dégrade (produit, client, commercial, canal), et décider vite (prix, remises, achats, mix).
Erreur classique : piloter une marge “catalogue” au lieu de la marge après remises, avoirs, transport, conditions spécifiques.
MDV : lignes de facture ou lignes de commande facturées + coûts (même approximatifs au début) + remises + avoirs.
Requêtes types :
- marge brute % par mois (12 mois),
- top 20 clients par CA et marge,
- bottom 20 lignes à marge négative,
- écart marge vs N-1 par famille produit,
- clients avec remise moyenne > X%.
Décision : stop remises, renégociation achats, hausse ciblée, nettoyage offres non rentables.
2) Retards et qualité de service : OTD, lead time, goulots
Objectif : arrêter de traiter les retards “au feeling”. Prioriser selon impact client et causes.
Erreur classique : un OTD basé sur une date promise jamais tenue à jour. Si la date promise est bidon, ton KPI est bidon.
MDV : commandes + date promise + date expédition/livraison + statuts + client + site + transporteur.
Requêtes types :
- OTD hebdo,
- retard moyen par transporteur,
- top clients impactés (nb commandes en retard et montant),
- lead time réel vs lead time “théorique”,
- retards par site/atelier.
Décision : ajuster promesse client, changer transport, re-prioriser production, traiter la cause racine.
3) Stocks : ruptures, surstocks, rotation
Objectif : libérer du cash sans casser le service client.
Erreur classique : stock théorique non fiabilisé, ou unités incohérentes (colis vs pièce), donc analyses inutilisables.
MDV : stock actuel + mouvements + ventes par SKU + délais d’appro + ruptures.
Requêtes types :
- top 50 surstocks (valeur immobilisée),
- top 50 ruptures (jours en rupture),
- rotation par famille,
- articles à faible rotation mais forte valeur,
- écart stock théorique vs inventaire (si dispo).
Décision : déstockage, arrêt de commande, ajustement mini/maxi, renégociation délais.
4) Impayés et risque client : DSO, relances, promesses non tenues
Objectif : réduire le DSO et limiter les mauvaises surprises de trésorerie.
Erreur classique : piloter uniquement “montant total dû”, sans segmenter par ancienneté ni par comportement client.
MDV : factures + échéances + statuts paiement + historique relances + client + assureur crédit si tu en as un.
Requêtes types :
- aging balance (0-30, 31-60, 61-90, 90+),
- DSO par mois,
- top 20 clients en dépassement d’échéance,
- taux de promesses de paiement non tenues,
- relances effectuées vs encaissements (efficacité).
Décision : blocage commandes, acompte, conditions de paiement, relance priorisée, escalade commerciale.
5) Prévisions de cash “praticables” : encaissements attendus vs réalité
Objectif : arrêter les surprises de trésorerie, même sans modèle sophistiqué.
Erreur classique : confondre CA facturé et cash encaissé, et oublier les décalages réels.
MDV : factures + échéances + paiements + encaissements réels + gros décaissements connus (URSSAF, TVA, salaires).
Requêtes types :
- prévision d’encaissement par semaine (4-8 semaines),
- écart prévision vs réalisé,
- clients “à risque” (retard récurrent),
- scénario prudent vs central (hypothèses explicites).
Décision : arbitrage dépenses, relances ciblées, négociation fournisseurs, ligne de trésorerie.
Si tu veux pousser ce sujet côté connexion outils, tu peux aussi lire : https://jimmymanin.com/blog/connecte-ton-ia-a-ta-treso-le-systeme-mcp-pour-piloter-ton-cash-sans-changer-donglet
6) Performance commerciale : pipe, taux de transfo, cycle, remises
Objectif : arrêter de piloter les commerciaux au “ressenti”. Piloter par conversion, vélocité, et marge.
Erreur classique : suivre seulement le pipe, sans qualité, sans probabilité réaliste, sans lien avec la marge.
MDV : CRM (opportunités) + devis + commandes + remises + motifs de perte si dispo.
Requêtes types :
- taux de conversion par étape,
- durée moyenne de cycle par segment,
- top motifs de perte,
- remise moyenne par commercial et par type de deal,
- pipeline “réaliste” (basé sur historique).
Décision : coaching ciblé, nettoyage pipe, ajustement process, cadrage politique de remise.
7) RH opérationnel : absentéisme, turnover, délai de recrutement
Objectif : voir tôt les signaux faibles (charge, équipes en tension), sans basculer dans la surveillance.
Erreur classique : sortir un KPI RH sans contexte, et déclencher des mauvaises décisions (ou des problèmes légaux).
MDV : effectifs (anonymisés si possible), absences, départs, recrutements (dates, postes), charge/planif si tu l’as.
Requêtes types :
- absentéisme par équipe (agrégé),
- turnover rolling 12 mois,
- délai de recrutement par poste,
- corrélation simple charge vs absences (prudence),
- alertes sur variations anormales.
Décision : ajustement staffing, priorisation recrutements, action managériale, prévention RPS.
Note : données sensibles. Accès ultra limité, agrégation, et règles d’usage strictes.
Prompts prêts à l’emploi pour lancer ton “pilotage PME” avec BI + ChatGPT
Oui, tu peux utiliser l’IA pour le reporting entreprise. Mais tu dois lui donner un cadre.
Prompt 1 : cadrage dirigeant (étape 1)
“Tu es mon contrôleur de gestion. Aide-moi à cadrer la question suivante : [question]. Produis 1 page avec : KPI exact, formule, dimensions d’analyse, exclusions, fréquence, seuils d’alerte, décision attendue, niveau de confiance requis, risques si la donnée est fausse.”
Prompt 2 : MDV (étape 2)
“À partir de ce cadrage, propose un jeu de données minimum viable : 1 table de faits + 2 à 5 dimensions max. Liste les champs, leur définition business, et qui doit être propriétaire de chaque champ (finance, sales, ops, etc.).”
Prompt 3 : 10 requêtes types (étape 3)
“Génère 10 requêtes types pour ce pilotage : 4 santé globale, 4 drivers, 2 anomalies. Donne la logique et la requête (SQL read-only). Ajoute aussi 5 tests de qualité de données.”
Prompt 4 : dashboard (étape 4)
“Conçois un dashboard 6 à 10 tuiles. Pour chaque tuile : définition, visuel recommandé, filtre, seuil d’alerte, action associée. Ajoute ‘dernière mise à jour’, source et niveau de qualité.”
Les limites (et les garde-fous) si tu ne veux pas te planter
1) Qualité des données : l’IA amplifie la saleté, elle ne la corrige pas
Si tes produits ne sont pas catégorisés, si les coûts sont faux, si les statuts ne sont pas tenus, tu auras des réponses “propres” sur des bases pourries.
À lire si tu veux un rappel cash : https://jimmymanin.com/blog/ton-ia-produit-des-resultats-nuls-le-vrai-coupable-cest-ta-data-sale
2) Droits d’accès : RBAC, sinon fuite interne assurée
Le pilotage touche vite à des données sensibles : marges par client, salaires, impayés. Tu dois imposer :
- rôles (qui voit quoi),
- périmètres (sources approuvées seulement),
- mode restrictif si besoin (limiter certaines capacités),
- traces (audit logs).
3) Risque majeur : décider sur des chiffres faux, parce que “ça a l’air crédible”
Un agent orienté données peut sortir une analyse très convaincante… même si :
- la période est mauvaise,
- un filtre est oublié,
- une colonne est mal interprétée,
- des doublons gonflent le CA.
Garde-fous minimum :
- requêtes figées et validées (pas du freestyle permanent),
- tests de qualité visibles (taux de champs manquants, doublons, outliers),
- double contrôle sur les KPI qui déclenchent du cash (prix, achats, relances, primes),
- définitions écrites (sinon tu changes de KPI sans t’en rendre compte).
4) Confidentialité, conformité, preuves
Le reporting généré par IA, les prompts, les décisions, tout ça peut devenir une trace. Donc tu cadres :
- ce qui est autorisé à demander,
- ce qui est interdit (données perso, RH nominatif, etc.),
- qui a le droit de partager les analyses.
Si tu veux cadrer le sujet “trace” et responsabilité : https://jimmymanin.com/blog/vos-prompts-peuvent-devenir-des-preuves-ce-que-tout-dirigeant-doit-cadrer
Plan d’action 48 heures (sans projet BI)
- Choisis 1 sujet parmi les 7. Celui qui touche cash ou marge d’abord.
- Écris la fiche étape 1 (métrique, décision, fréquence, seuils).
- Définis ton MDV (1 table de faits + 2 à 5 dimensions).
- Liste 10 requêtes types et 5 tests qualité. Tu les figes.
- Construis un mini-dashboard 6 à 10 tuiles avec “dernière mise à jour” et “qualité”.
- Pose les garde-fous : accès, read-only, audit, définitions écrites.
Si tu fais ça, tu obtiens un vrai pilotage PME avec de la BI avec ChatGPT, sans chantier à 6 chiffres. Et surtout, tu remets le reporting à sa place : un outil pour décider vite, pas une usine à slides.