Le vrai sujet n’est plus “aller vite”. C’est “pouvoir prouver”.
Tu veux automatiser un contrôle sensible. Typiquement : valider une opération, une facture, un devis, un contrat, une note de frais, une conformité, un contrôle qualité.
Sur le papier, l’IA te promet 10x plus vite. En vrai, si tu automatises “à l’aveugle”, tu crées un nouveau risque : l’erreur invisible. Celle qui passe parce que “l’IA l’a dit”. Et le jour où ça dérape, tu n’as rien pour répondre à ces trois questions basiques :
- Sur quelles preuves la décision a été prise ?
- Avec quelles règles (et quelle version) ?
- Qui a validé, et quand ?
Le marché bouge dans ce sens : on passe de la performance à la gouvernance. Gartner anticipe d’ailleurs une hausse nette des budgets de plateformes de gouvernance IA, signe que l’auditabilité devient un poste à part entière.
Et même si tu n’es pas un “système à haut risque”, la logique réglementaire qui arrive (type AI Act) est limpide : si c’est sensible, tu logges. Traçabilité, journalisation, conservation. Pas pour faire joli. Pour pouvoir tenir en audit, en litige, en contrôle interne, ou juste face à ton CAC/DAF.
Cas concret : validation d’opérations, de 30 minutes à 4 minutes (sans roulette russe)
Le cas le plus fréquent en PME/ETI : un contrôle “compta/finance/ops” qui mélange documents et règles.
Exemple simple : valider une facture fournisseur avant paiement.
- Tu ou ton équipe ouvrez la facture.
- Vous cherchez le bon de commande, le devis, la réception.
- Vous vérifiez montants, TVA, IBAN, dates, SIRET, conditions, imputation analytique.
- Vous comparez aux règles internes (seuils, délégations, fournisseurs à risque, exceptions).
- Vous documentez à moitié (ou pas), parce que “pas le temps”.
30 minutes quand tout est dispersé. Et quand il y a une exception, ça part en ping-pong.
En automatisation IA, le piège classique c’est : OCR + LLM + “OK/KO”. Rapide. Mais non vérifiable. Et quand ça se trompe, tu ne sais pas où ni pourquoi.
La méthode “auditabile”, c’est l’inverse : tu forces le système à produire un dossier de preuve, puis une décision, puis une trace. Résultat : 4 minutes pour la majorité des cas, et des exceptions gérées proprement.
La méthode “auditabile” : un patron réutilisable pour tout contrôle sensible
Objectif : gagner du temps sans créer un risque d’erreur invisible.
Le patron tient en 6 blocs, toujours dans le même ordre :
- 1) Collecte des preuves (les bons documents, la bonne version)
- 2) Extraction structurée (des champs, pas du blabla)
- 3) Comparaison à des règles (explicites, versionnées)
- 4) Gestion des exceptions (seuils, ambiguïtés, données manquantes)
- 5) Double validation humaine (au bon endroit, pas partout)
- 6) Journalisation (audit trail exploitable)
Ce patron marche pour : automatisation IA contrôle factures, validation devis, contrôle contrats, conformité, qualité, contrôle interne, et même certains contrôles RH (avec prudence sur les données perso).
1) Collecte des preuves : sans preuves récupérables, ton IA inventera
Tu veux réduire les hallucinations ? Commence par rendre la preuve disponible et récupérable.
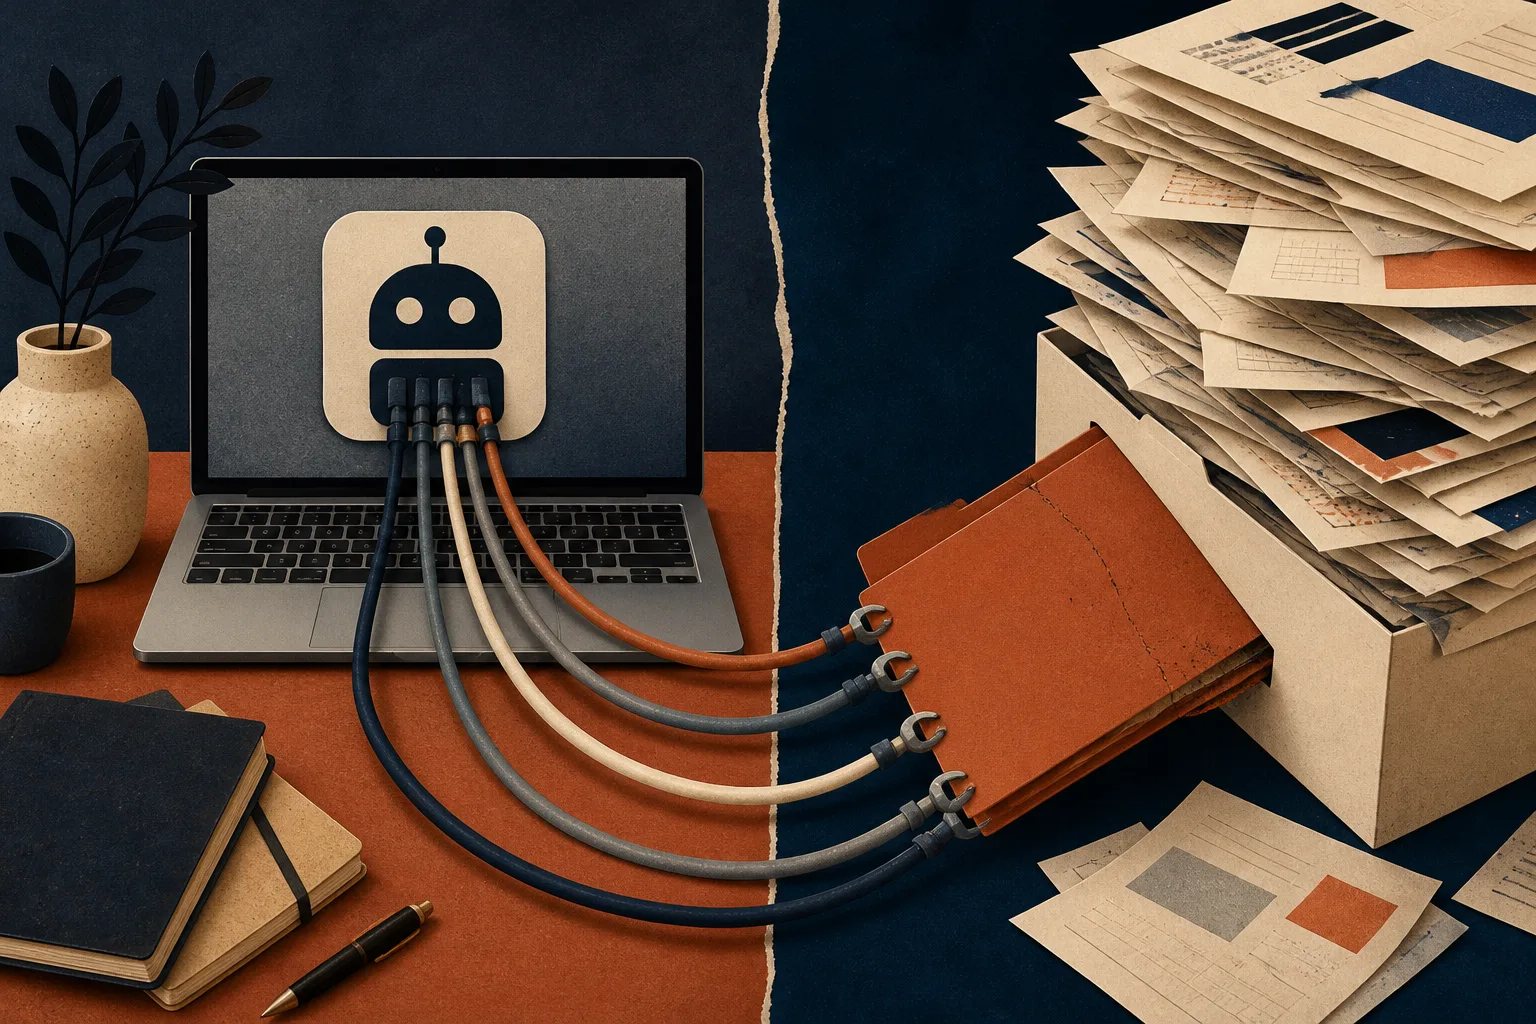
Dans l’entreprise, ça veut dire : mettre en place un petit RAG (retrieval) ou une recherche documentaire simple, mais cadrée.
Règle terrain : le système ne doit pas “se souvenir”, il doit “retrouver”.
Checklist “preuves” (factures et opérations)
- La facture PDF (source) + ses métadonnées (date réception, canal, fournisseur).
- Le bon de commande, ou à défaut le devis signé.
- La preuve de livraison/réception (BL, mail, ticket, rapport).
- Les règles internes applicables (seuils, délégations, exigences TVA, RIB validé).
- Le référentiel fournisseur (SIRET, IBAN autorisés, statut “à risque”).
Le cadrage “RAG analyse documents entreprise” utile
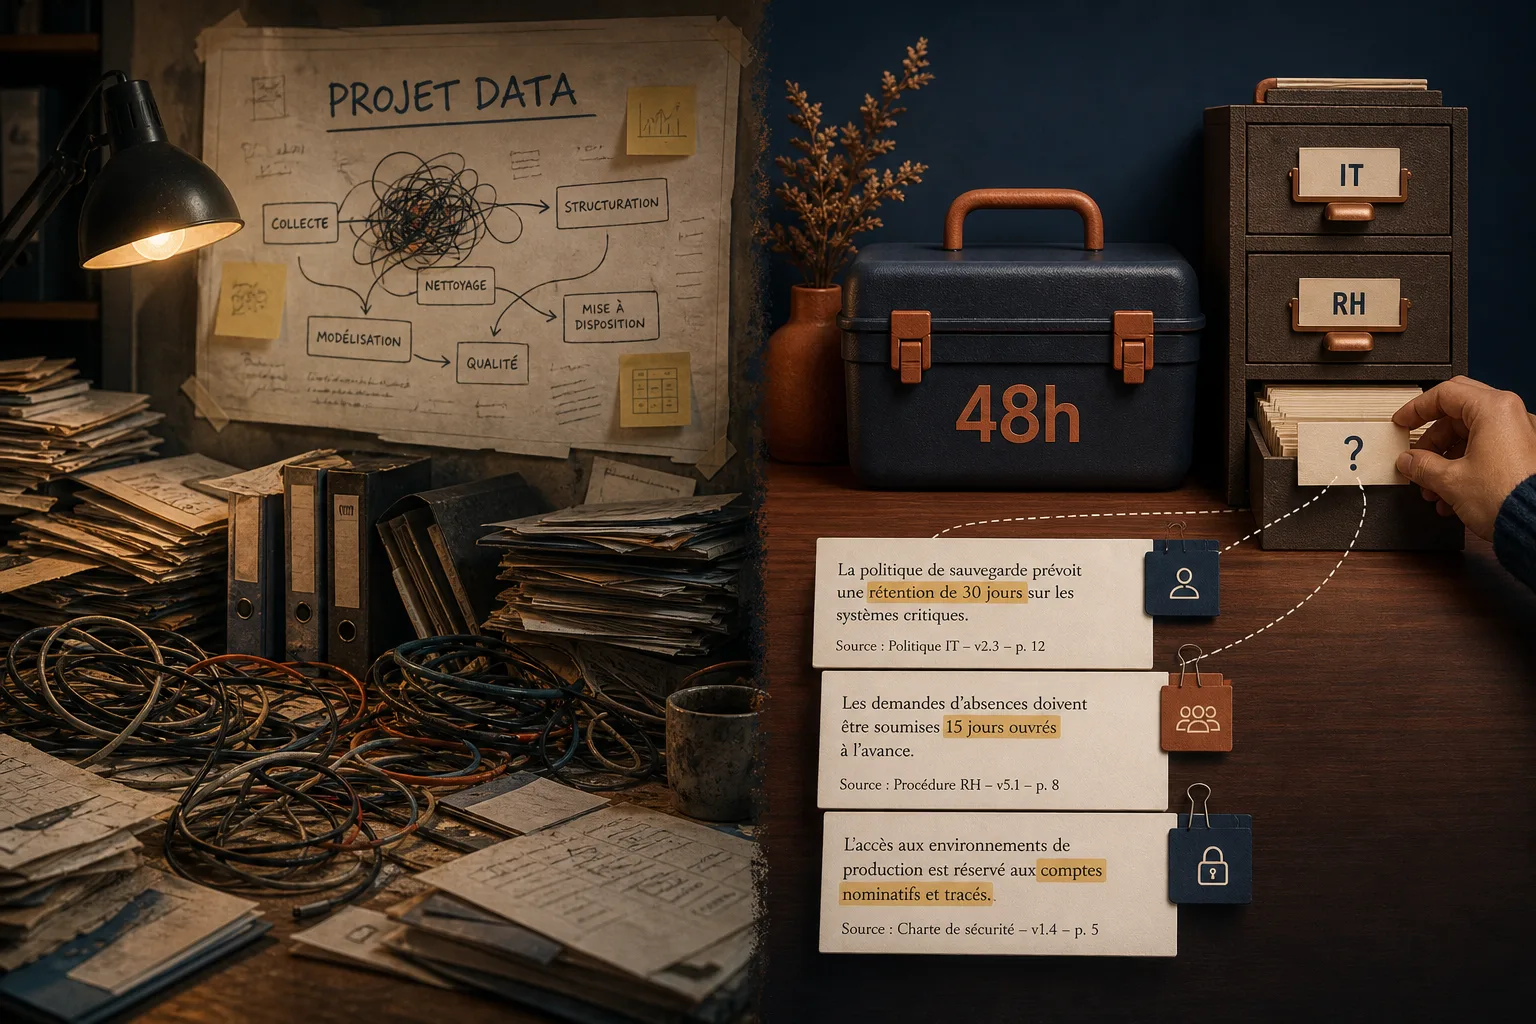
RAG oui, mais pas “un chatbot qui lit SharePoint”. Tu veux un retrieval qui renvoie :
- Des extraits courts (phrase, ligne de tableau), pas juste “document X”.
- Un lien vers la source + page + zone.
- Une version (date, hash, ID) si possible.
Important : la recherche montre que le RAG réduit souvent les hallucinations, mais ne garantit pas zéro erreur. Et si tes citations restent au niveau paragraphe, l’auditabilité reste faible. Donc tu dois pousser vers des preuves fines.
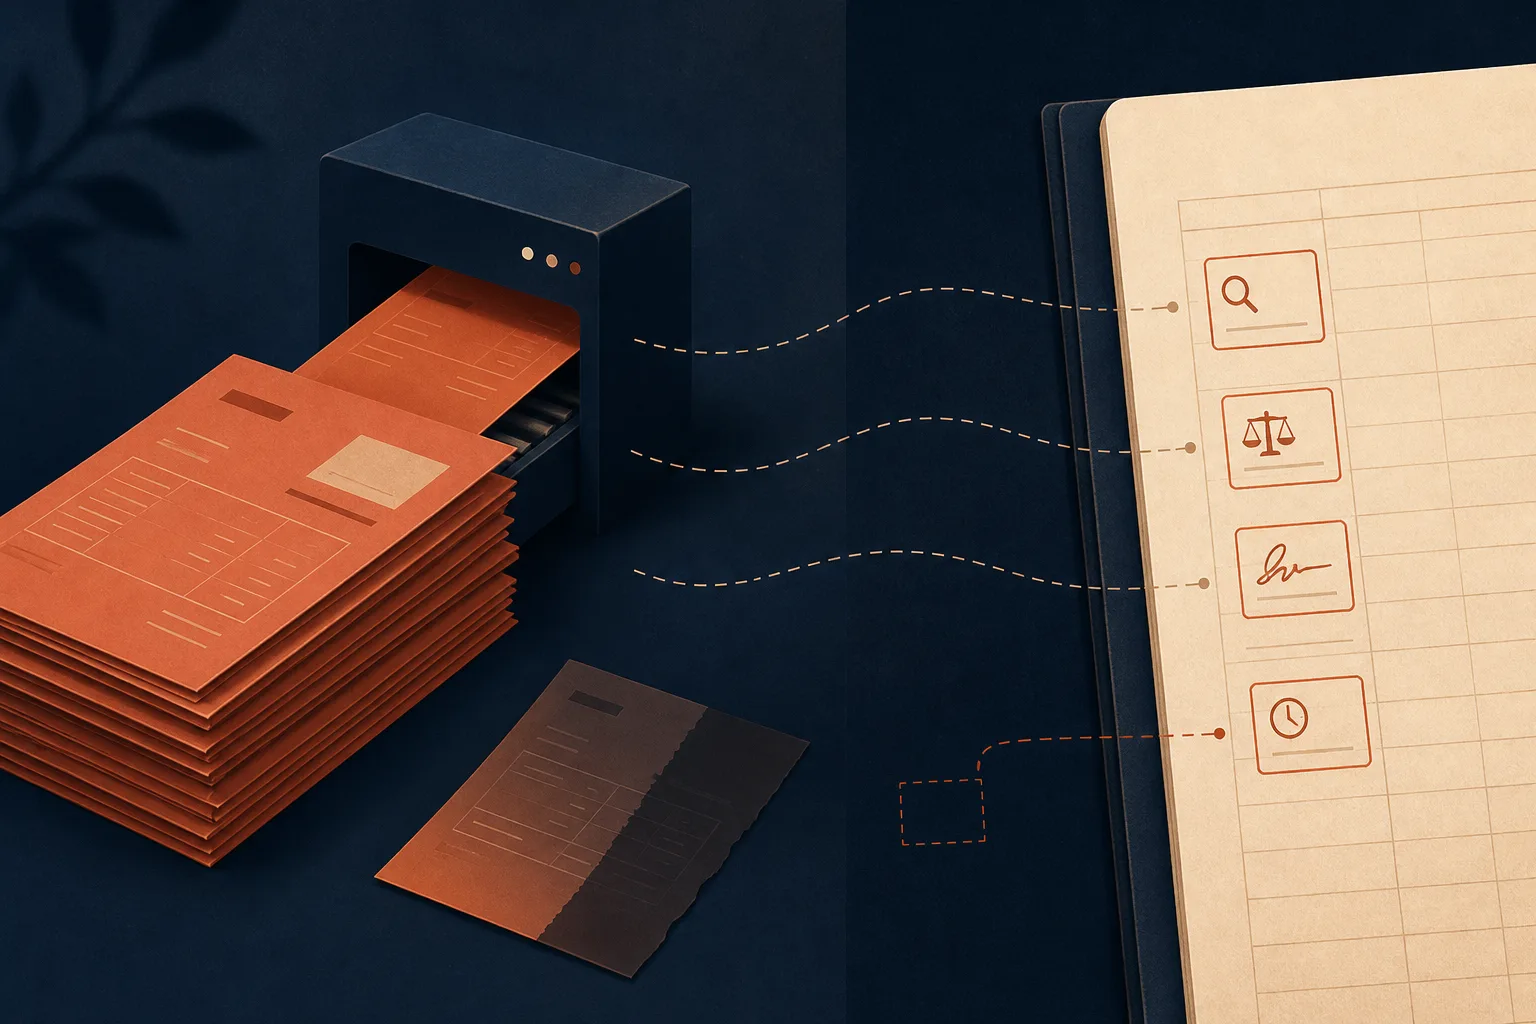
2) Extraction structurée : tu veux des champs, pas une explication
Deuxième piège : laisser l’IA “raconter” ce qu’elle a compris. Toi, tu veux des données structurées, testables.
Exemple facture : l’IA doit produire un JSON (ou une ligne table) avec :
- fournisseur_nom, fournisseur_siret
- facture_numero, facture_date
- montant_ht, tva, montant_ttc, devise
- iban_facture (si présent), iban_ref (référentiel)
- commande_ref, devis_ref, reception_ref
- lignes (désignation, quantité, prix, total)
- preuves associées à chaque champ (source, page, extrait)
La règle “auditabile” : pas de champ sans preuve.
Astuce simple qui change tout
Au lieu de demander “analyse cette facture”, tu demandes :
- Extraction champ par champ
- Pour chaque champ : citation exacte + localisation (page)
- Si le champ manque : valeur “null” + raison
Oui, c’est plus strict. Et c’est exactement ce qui te fait gagner du temps après, parce que tu ne repasses pas derrière pour comprendre d’où sort l’info.
3) Comparaison à des règles : l’IA ne doit pas “juger”, elle doit “tester”
Troisième piège : demander à l’IA si “c’est OK”. Elle va improviser. Parfois bien. Parfois non. Et tu ne pourras pas expliquer.
À la place : tu écris des règles explicites. Même simples. Même imparfaites. Mais écrites.
Exemples de règles “contrôle factures”
- R1 : si montant_ttc > 5 000 €, alors validation niveau 2 obligatoire.
- R2 : si iban_facture != iban_ref, alors exception “RIB mismatch”.
- R3 : si commande_ref absente ET devis_ref absent, alors exception “Pas de pièce amont”.
- R4 : si TVA manquante ou incohérente, alors exception “TVA”.
- R5 : si écart lignes commande vs facture > 2%, alors exception “Ecart prix”.
Et surtout : tu versionnes tes règles. Règles v1.2, appliquées le 02/11/2026. Comme un mini contrôle interne.
Ce que l’IA fait vraiment ici
- Elle récupère les preuves (RAG).
- Elle extrait des champs (structuré).
- Elle exécute des tests (logique).
- Elle produit un rapport de contrôle lisible + vérifiable.
Là, tu n’as pas “un avis IA”. Tu as un contrôle reproductible.
4) Gestion des exceptions : tu gagnes du temps parce que tu assumes que ça va coincer
Les contrôles réels échouent rarement sur les cas “propres”. Ils échouent sur :
- une pièce manquante,
- un scan illisible,
- un libellé ambigu,
- un changement fournisseur,
- un avoir,
- un cas hors process.
La méthode “auditabile” impose un mode exception-first : tu définis à l’avance ce que le système fait quand il n’est pas sûr.
Règles d’exception (simples et efficaces)
- Seuil de confiance : si l’extraction d’un champ critique n’a pas de preuve claire, alors “exception”.
- Données manquantes : si une pièce amont manque, le système crée une tâche “demande doc” (au bon owner).
- Conflit : si deux documents se contredisent, le système classe “conflit” et liste les deux extraits.
- Silence interdit : pas de “ça doit être bon”. Si doute, ça remonte.
Tu veux réduire temps de contrôle ? Réduis le temps passé à comprendre l’exception. L’IA doit faire le tri, pas trancher à ta place.
5) Double validation humaine : pas partout, au bon endroit
Si tu automatises un contrôle sensible, le bon modèle est souvent : IA prépare, humain décide. Mais pas n’importe comment.
La double validation “auditabile” (2 niveaux)
- Niveau A (opérationnel) : un humain valide que les preuves et champs sont corrects pour les cas standards.
- Niveau B (responsable) : un humain valide les exceptions et les montants sensibles (seuils, nouveaux fournisseurs, RIB, etc.).
Tu peux lier ça à une délégation de pouvoir existante. Et tu gardes une règle simple : tout ce qui peut coûter cher ou créer un risque légal ne passe pas en “auto-approve”.
Pour le principe “double validation”, tu peux aussi t’inspirer du protocole déjà posé sur le site (utile même hors fraude) : https://jimmymanin.com/blog/fraude-a-la-voix-deepfake-le-protocole-double-validation-en-30-minutes
6) Journalisation : ton “IA audit trail” doit être exploitable, pas décoratif
Sans logs, tu n’as pas d’automatisation “sensible”. Tu as juste une magie noire rapide.
Ton audit trail doit permettre de reconstruire l’histoire en 2 minutes :
- Quel document a été contrôlé (ID, version, hash si possible) ?
- Quels autres documents ont été utilisés comme preuves ?
- Quelles règles ont été appliquées (version) ?
- Quel modèle/outillage a tourné (nom, version, paramètres clés) ?
- Quel résultat (OK/KO + liste d’exceptions) ?
- Qui a validé (niveau A/B) ?
- Quelle action a été déclenchée (paiement, mise en attente, demande pièce) ?
La direction prise par la régulation européenne insiste sur la traçabilité et la conservation des logs (au moins 6 mois dans certains cas quand tu contrôles ces logs). Même si tu n’es pas “high-risk”, le réflexe est bon : si c’est sensible, conserve la trace.
Point vigilance : journaliser ne veut pas dire tout garder n’importe comment. Tu minimises les données, tu gères la rétention, et tu cadres l’accès. Si tu dois traiter des données perso, fais-le proprement. (Sur l’anonymisation, tu as un plan terrain ici : https://jimmymanin.com/blog/anonymisation-et-ia-en-entreprise-plan-terrain-en-6-etapes-pour-partager-utile-sans-risque-rgpd)
Le workflow “auditabile” minute par minute (objectif 4 minutes)
Voilà un déroulé type sur une facture standard.
Minute 0 à 1 : ingestion + retrieval
- Le PDF arrive (mail, GED, portail, EDI).
- Le système retrouve automatiquement : BC, devis, BL, référentiel fournisseur, règles.
- Il prépare un “dossier de contrôle” avec liens et versions.
Minute 1 à 2 : extraction structurée + preuves
- Extraction des champs critiques.
- Association preuves champ par champ (extrait + page).
Minute 2 à 3 : exécution des règles + scoring d’exception
- Application des règles versionnées.
- Sortie : OK, ou liste d’exceptions classées par risque.
Minute 3 à 4 : validation humaine (si OK) ou routage (si exception)
- Cas OK : validation niveau A en 20 secondes, parce que tout est déjà sourcé.
- Cas exception : routage vers niveau B, avec résumé factuel + preuves.
Patron réutilisable : devis, contrats, conformité, qualité
Tu peux copier-coller la structure “auditabile” sur d’autres contrôles.
Devis
- Preuves : demande client, grille tarif, remise autorisée, conditions.
- Règles : seuil remise, marge min, clauses obligatoires.
- Exceptions : nouveau client, atypie prix, clause manquante.
Contrats
- Preuves : modèle clause, version jur, annexes, échanges.
- Règles : clauses interdites, durées, RGPD, pénalités, plafonds.
- Exceptions : clause modifiée, ajout manuel, incohérence annexe.
Conformité / qualité
- Preuves : procédure, checklists, résultats tests, photos, logs machine.
- Règles : tolérances, normes internes, fréquences de contrôle.
- Exceptions : mesure hors tolérance, pièce non traçable.
Décisions de dirigeant : ce que tu cadres avant de lancer
- Quel risque maximum acceptable sur une erreur (argent, légal, image) ?
- Quels champs sont “critiques” (ceux qui déclenchent une exception si doute) ?
- Qui valide quoi (niveau A/B, seuils, délégations) ?
- Où sont les preuves et qui en est owner (GED, ERP, Drive, mails) ?
- Quelle rétention de logs et qui peut les consulter ?
- Quel plan de continuité si le modèle change, baisse en qualité ou tombe (ça arrive) ?
Sur ce dernier point (continuité), tu as un plan concret ici : https://jimmymanin.com/blog/depreciation-des-modeles-llm-plan-de-continuitie-en-10-points-pour-eviter-la-panne
Template prêt à l’emploi : le “dossier de contrôle” auditabile
Si tu dois démarrer vite, impose ce format de sortie. Peu importe l’outil. Tu veux ce bloc, systématiquement :
- ID contrôle, date/heure, initiateur
- Objet : facture X, opération Y
- Sources : liste des documents avec liens + versions
- Extraction structurée : champs + preuve par champ
- Règles appliquées : liste + version + résultat par règle
- Exceptions : type, gravité, action demandée
- Décision : approuvé / rejeté / en attente
- Validation humaine : qui, niveau, commentaire
- Journal : horodatage des étapes, modèle utilisé, paramètres clés
Si ton automatisation ne sait pas produire ça, elle n’est pas “sensible-ready”. Point.
Ce que tu fais cette semaine (plan simple, applicable)
Tu veux tester la réduction temps de contrôle sans te mentir ? Fais ça :
- Étape 1 (30 min) : prends 20 contrôles réels (factures ou opérations), dont 5 avec exceptions.
- Étape 2 (45 min) : écris 10 règles maximum, ultra claires, version v1.0.
- Étape 3 (60 min) : définis 8 champs critiques + “pas de champ sans preuve”.
- Étape 4 (60 min) : mets en place la sortie “dossier de contrôle” (même à la main au début).
- Étape 5 (60 min) : teste, mesure : temps par contrôle, taux d’exceptions, temps de traitement des exceptions.
Si tu ne mesures pas les exceptions, tu vas te faire piéger par la “taxe de vérification” : tu crois gagner du temps, mais tu le repayes en relecture et en doutes. (À garder en tête : https://jimmymanin.com/blog/taxe-de-verification-eviter-que-lia-te-fasse-perdre-du-temps-pas-en-gagner)
Le point clé à retenir
Une automatisation IA sensible qui marche, ce n’est pas “l’IA décide”. C’est :
- preuves récupérables,
- extraction structurée,
- règles explicites,
- exceptions assumées,
- double validation là où ça compte,
- IA audit trail propre.
Tu passes de 30 minutes à 4 minutes sur les cas standards, sans transformer ton contrôle interne en casino. Et surtout : si un jour quelqu’un demande “pourquoi tu as payé ça ?”, tu as la réponse, preuves à l’appui.